Lectura ejecutiva · ~60 segundos
Un advisory y dos preprints del corte del 10/09/2026 apuntan al mismo contrato: validar cada efecto, detener loops mediante evidencia objetiva y usar el consenso para priorizar la revisión, no para autocertificar una salida. Es una síntesis técnica; no afirma explotación activa ni controles que ya estén operando en Forge.
Un agente no se vuelve confiable porque recibió una ronda más, porque otro modelo estuvo de acuerdo o porque la primera dirección consultada estaba permitida. Tres hallazgos publicados en el mismo corte muestran el mismo problema desde ángulos distintos: los controles deben acompañar la ejecución real, tener una condición objetiva de parada y preservar evidencia independiente de la generación.
Este Evidence Brief convierte un advisory y dos preprints en un contrato defensivo. No publica pasos ofensivos, no generaliza benchmarks a todo el desarrollo de software ni afirma que estos controles estén implantados, probados u operando en Trustyu Forge. El texto fue aprobado editorialmente el 10/09/2026; la publicación efectiva se regularizó el 15/09/2026.
El paquete de evidencias
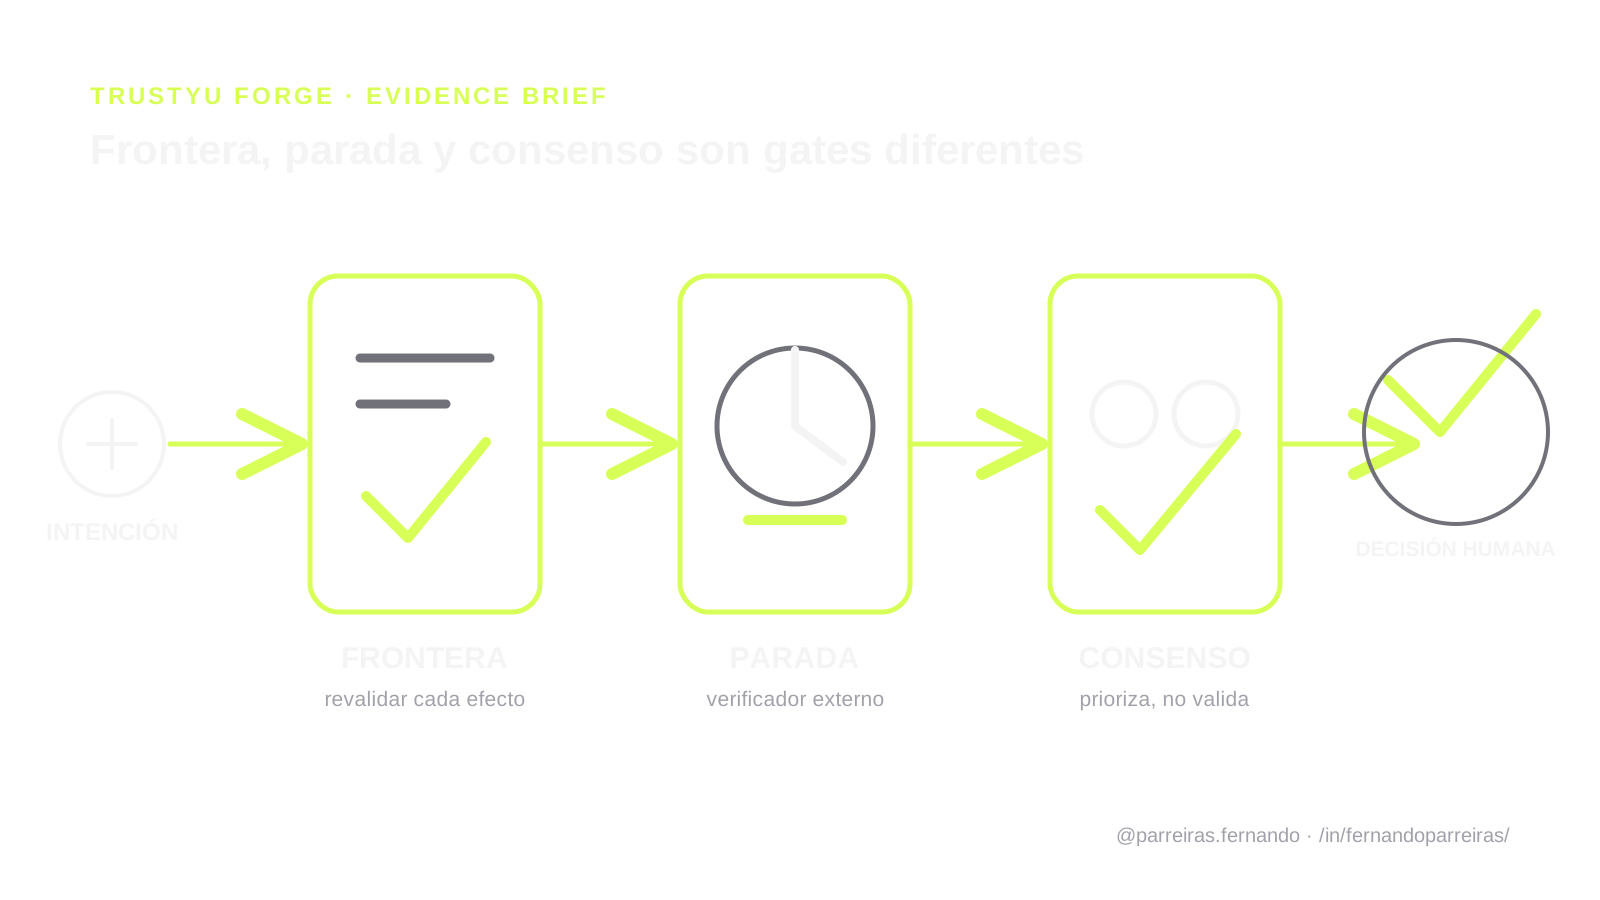
1. Frontera: cada salto debe reevaluarse
El advisory oficial GHSA-5x7x-4c3c-qf5w describe una SSRF en Open WebUI. El rango afectado es 0.9.5 a 0.11.0; la corrección está en 0.11.1. La precondición importa: AIOHTTP_CLIENT_ALLOW_REDIRECTS=true, mientras que el valor predeterminado es false. Según el advisory, la validación cubría la URL inicial, pero no el destino efectivo después de los redirects. El proyecto informa reproducción en la versión 0.11.0 y bloqueo en la 0.11.1.
Actualizar corrige el caso descrito, pero existe una salvedad operativa: cuando el tráfico sale por un forward proxy, la restricción de destinos privados también debe aplicarse en el propio proxy. El caso no demuestra explotación activa ni prevalencia de SSRF en productos de IA. Demuestra una propiedad: la política debe aplicarse en cada destino efectivo, no solo en la intención inicial.
2. Parada: seguir corrigiendo puede crear regresiones
El preprint If It's Not Buggy, Don't Fix It, versión 1 del 09/09/2026, estudió la reparación iterativa a ciegas en 20 problemas, con 40 entregas C++ por problema, dos modelos y hasta 100 turnos. En las configuraciones evaluadas, los modelos afirmaron encontrar problemas en código correcto y con frecuencia dañaron código correcto a una tasa igual o superior a la corrección de código defectuoso. El estudio también observó ciclos en los que se añadían y eliminaban cambios.
El resultado no permite afirmar que «la IA empeora el código» en general. El recorte usa tareas competitivas de un solo archivo, dos modelos, objetivos ambiguos y ausencia de historial en el loop. Sustenta una conclusión más precisa: sin un verificador objetivo y una condición externa de parada, una iteración adicional no es evidencia de mejora.
3. Consenso: la variedad puede priorizar, no validar
El preprint Ensembling LLMs for AI-Augmented Cybersecurity Software Requirements Generation, también versión 1 del 09/09/2026, evaluó 24 ejecuciones, 12 configuraciones, cuatro familias de modelos y diez controles de ISO/IEC 27002:2022. El estándar de referencia contenía 72 requisitos considerados válidos por especialistas. Reunir todas las salidas recuperó los 72, pero añadió 111 alucinaciones. La fusión mejoró la ordenación de las sugerencias; no convirtió el acuerdo en verdad.
El estudio tiene el corpus y el código archivados en Zenodo, lo que mejora la auditabilidad. Aun así, es un caso en inglés sobre un solo sistema, un solo estándar y un juicio especializado. No mide si los requisitos generados evitan incidentes ni sustituye el análisis de riesgos.
El contrato técnico
intenção
   │
   ▼
fronteira por efeito ──► execução limitada ──► verificador externo
   │                            │                     │
   └── política em cada salto   └── orçamento        └── parar, reverter ou promover
                                                        │
                                                        ▼
                                                evidência + decisão humana
Un harness duradero debe mantener la política, el historial de la sesión y el aislamiento de ejecución como fronteras explícitas. Los adaptadores o la elección de modelo no pueden convertirse en el límite de seguridad. Esta es una inferencia de diseño respaldada por el canon actual, no una declaración de operación de Forge. [HARNESS31-C2]
Gate A — la frontera acompaña el efecto
- valide de nuevo el destino, la identidad y la autoridad en cada redirect, resolución y hop del proxy;
- aplique la política en el componente que realmente abre la conexión o produce el efecto;
- mantenga un egress mínimo y restricciones equivalentes en el proxy;
- registre la URL por clase y decisión sin conservar secretos, direcciones sensibles ni contenido íntegro;
- falle de forma cerrada cuando no pueda determinarse el destino efectivo.
Gate B — la parada es externa al mismo loop
- preserve una baseline inmutable, pruebas y requisitos antes del primer cambio;
- defina presupuestos de turnos, tiempo, coste y tamaño del diff;
- deténgase cuando el verificador objetivo no mejora o cuando aparece una regresión;
- detecte ciclos mediante un digest de estado y revierta al último punto comprobado;
- eleve la ambigüedad al juicio humano en lugar de premiar la actividad.
Gate C — el consenso organiza la cola
- mantenga las salidas independientes antes de la fusión;
- separe la recuperación de candidatos, el ranking y la validación;
- use un estándar de referencia o un evaluador independiente del generador;
- preserve el desacuerdo, la procedencia y la confianza por requisito;
- trate el consenso como prioridad de revisión, nunca como autorización automática.
Receipt mínimo
{
  "input_ref": "immutable-ref",
  "policy_digest": "sha256:...",
  "effective_boundary": "bounded",
  "iteration_budget": {"max_turns": 12, "used": 7},
  "verifier_result": "pass|fail|inconclusive",
  "cycle_detected": false,
  "candidate_sources": ["model-a", "model-b"],
  "human_decision": "promote|revise|reject",
  "effect_receipt": "immutable-ref"
}
Los valores son ilustrativos. El receipt debe emitirse fuera de la autoridad del agente y preservar solo lo necesario para reconstruir versión, política, límite, verificación y decisión.
Pruebas negativas
- Un destino inicial permitido no autoriza automáticamente el destino después de un redirect.
- Un proxy no puede ampliar los destinos que bloquea la política del cliente.
- El código inicialmente correcto no puede promoverse si la iteración reduce pruebas o invariantes.
- Los estados repetidos interrumpen el loop y producen evidencia de un ciclo.
- El acuerdo entre dos modelos no elimina la necesidad de una fuente, una prueba o una aprobación responsable.
- La suma de candidatos no puede ocultar falsos positivos ni alterar el denominador.
inconclusiveno se convierte enpasspor agotamiento del presupuesto.- El fallo del verificador no autoriza al generador a autocertificar su propia salida.
Gate de release
- ¿Se verifica el destino efectivo en todos los hops y en el proxy?
- ¿El efecto exige identidad y capacidad compatibles?
- ¿Son recuperables el estado inicial y el último estado comprobado?
- ¿Existe un límite explícito de turnos, coste, tiempo y mutación?
- ¿El verificador es independiente del loop que propone el cambio?
- ¿Los ciclos y las regresiones interrumpen y revierten la ejecución?
- ¿La fusión preserva falsos positivos, desacuerdos y procedencia?
- ¿La decisión humana está vinculada al artefacto exacto aprobado?
- ¿El Evidence Packet distingue bloqueo, fallo y resultado no concluyente?
Superar el gate demuestra solo el alcance ejercitado. No demuestra seguridad total, ausencia de vulnerabilidades, calidad universal ni operación continua.
Limitaciones y conflictos de interés
- El advisory de Open WebUI es una fuente oficial del proyecto y describe la condición, reproducción y corrección; no es una medición independiente de explotación en el mundo real.
- Los dos estudios son preprints recientes, todavía sin revisión por pares registrada en arXiv.
- El estudio de bug-fixing tiene autores vinculados a UnlikelyAI; parte del trabajo se realizó durante una estancia en la empresa. Esto no invalida el método, pero debe acompañar la lectura.
- El estudio de requisitos usa un solo caso, un estándar y un equipo especializado; sus cifras no representan prevalencia de mercado.
- Trustyu y Tech Human operan comercialmente en arquitectura, gobernanza e ingeniería de IA.
Fuentes directas
- Open WebUI — GHSA-5x7x-4c3c-qf5w.
- Open WebUI — release v0.11.1.
- Wang-Lin, Isopoussu y Mahon — arXiv:2609.10123v1.
- Texto experimental completo de arXiv:2609.10123v1.
- Perez-Acuna, Martín y Yelmo — arXiv:2609.10316v1.
- Artefactos del estudio de requisitos — Zenodo.
Nota editorial y de responsabilidad
Los hechos, cifras y versiones están vinculados a las fuentes indicadas. El contrato, los gates y las recomendaciones son el análisis profesional del autor, no hechos universales ni afirmaciones de que los controles ya estén operando. El contenido es informativo y no sustituye una evaluación técnica, jurídica o de seguridad. La investigación, estructura y redacción tuvieron asistencia de IA; Fernando Parreiras confirmó la revisión factual y autoral y la aprobación de publicación el 10/09/2026. No hubo revisión humana independiente adicional.
Nota editorial y de responsabilidad
- Corte de la investigación
- Última revisión
- Correcciones registradas
- No hay correcciones registradas.
El corte anterior corresponde a los claims canónicos. Las fuentes complementarias y sus fechas de consulta se identifican en el cuerpo del artículo.
Este artículo combina fuentes citadas, análisis y experiencia profesional del autor. Los datos verificables y las afirmaciones fácticas están vinculados a sus respectivas fuentes. Las interpretaciones, hipótesis, proyecciones, recomendaciones y opiniones representan el punto de vista profesional del autor en el momento de la publicación; no constituyen hechos probados, promesas de resultados ni asesoramiento jurídico, financiero o técnico aplicable a un caso concreto. Consulte las fuentes originales y a profesionales cualificados antes de tomar decisiones.
Claims y fuentes
HARNESS31-C2
Un harness duradero debe mantener el historial de sesiones, la política de orquestación y el aislamiento de ejecución como límites explícitos, mientras que los adaptadores y complementos evitan que la elección del modelo o canal se convierta en el límite de seguridad.
Límite: Las fuentes muestran dos implementaciones, no un estándar de interoperabilidad neutral. Los permisos reales deben aplicarse y probarse de forma independiente fuera de las opciones del modelo. Este es un input de diseño source-bound; no prueba la adopción del producto, la madurez operativa, la attestation independiente, la clasificación de búsqueda, la citación de IA o el resultado.
- Anthropic — Anthropic, términos de sitio propietario
- Software YC —Software YC, MIT
- Software YC —Software YC, MIT