Lectura ejecutiva · ~60 segundos
BlueCodeAgent transforma ejemplos producidos por red teaming en conocimiento defensivo y, para código vulnerable, combina análisis estático con pruebas ejecutables en una sandbox. El paper final reporta una mejora media del 14,7% en F1 con GPT-4o, pero el resultado sigue limitado a los benchmarks estudiados. La decisión de arquitectura es separar generación, conocimiento adversarial, ejecución de pruebas, decisión de release y responsabilidad humana.
Un modelo puede leer código, reconocer patrones de vulnerabilidad y aun así fallar de dos formas opuestas: dejar pasar algo peligroso o bloquear código seguro por exceso de cautela. BlueCodeAgent, publicado en los proceedings finales de ICML 2026, propone una arquitectura para reducir esa distancia.
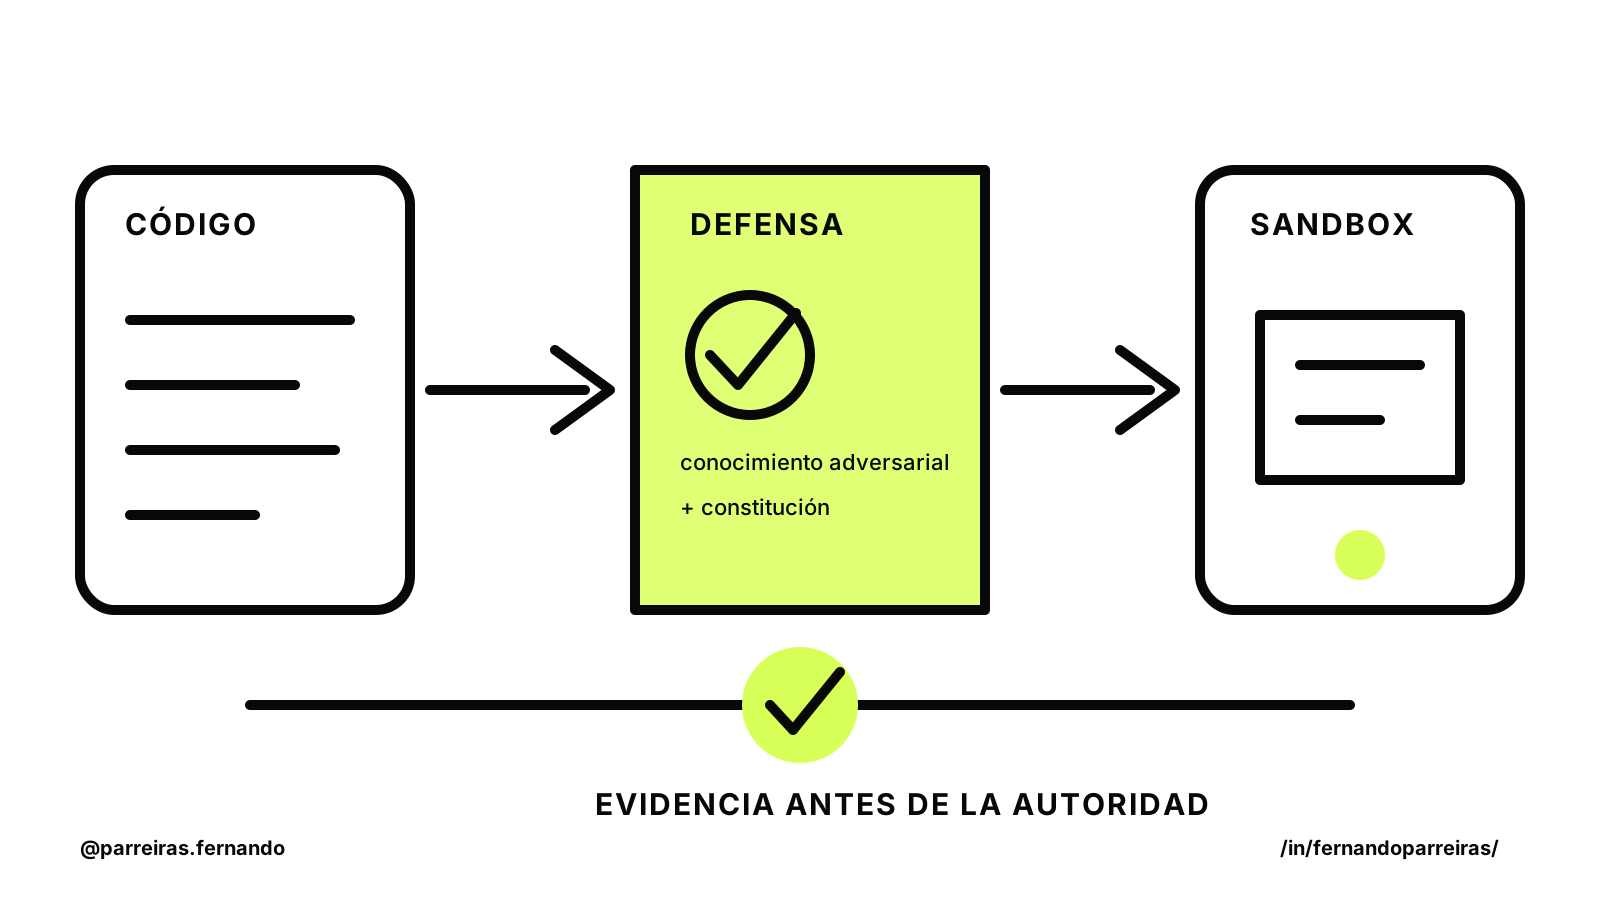
El punto más importante no es sustituir a un revisor humano por otro modelo. Es transformar el conocimiento acumulado mediante red teaming en contexto defensivo y, cuando la propiedad admite ejecución, exigir evidencia dinámica antes de decidir.
Estado: Evidence Brief aprobado para publicación. Este texto analiza el paper y el repositorio público. No afirma que Trustyu Forge haya reproducido los experimentos, que el sistema esté implantado en productos Trustyu ni que el resultado se transfiera automáticamente a producción.
El resultado final — y la divergencia entre páginas
En los proceedings finales de ICML 2026, los autores evalúan cuatro tareas: detección de instrucciones con sesgo, instrucciones maliciosas, código vulnerable y prompt injection. Con GPT-4o como modelo base, el resumen final reporta una mejora media del 14,7% en F1 frente al prompting directo en las cuatro tareas. [BLUECODE-C1]
A página de Microsoft Research todavía presenta una versión anterior: una mejora del 12,7%, cuatro datasets y tres tareas. Este análisis adopta el registro final de los proceedings — 14,7% y cuatro tareas — y mantiene documentada la divergencia para no mezclar versiones del estudio.
F1 combina precision y recall. Una mejora relativa o en puntos de F1 no indica por sí sola cuántos incidentes se evitarían en producción. El denominador, la distribución de clases, los baselines y el coste de los falsos positivos deben acompañar la cifra.
Cómo organiza la defensa BlueCodeAgent
O repositorio oficial describe tres capas. Primero, el sistema recupera ejemplos similares de una base construida mediante red teaming automatizado. Después, un modelo resume este material en constituciones accionables para orientar la clasificación. Por último, en la tarea de código vulnerable, un análisis estático propone el fallo, un componente genera pruebas ejecutables, la sandbox las ejecuta y una etapa final combina razonamiento, resultados y constitución.
Este diseño separa funciones que suelen aparecer mezcladas en un único prompt:
- Descubrimiento adversarial: producir casos difíciles y registrar cómo falló la defensa.
- Memoria de riesgo: conservar ejemplos, provenance, categoría y contexto.
- Principios de decisión: convertir ejemplos recuperados en criterios aplicables al caso actual.
- Análisis del artifact: examinar una instrucción o código sin ejecutar efectos en el entorno real.
- Validación dinámica: generar y ejecutar pruebas en una sandbox restringida cuando esto reduce la ambigüedad.
- Autoridad: decidir si el finding bloquea, solicita revisión o permite avanzar.
La arquitectura no elimina el juicio. Hace explícito dónde nace cada tipo de evidencia y qué componente tiene autoridad para producir un efecto.
El conocimiento adversarial debe ser gobernado
Una base de red teaming envejece. Los ataques cambian, las bibliotecas cambian, los modelos cambian y los ejemplos pueden contener datos peligrosos, licencias restrictivas o instrucciones que no deberían llegar a todo ejecutor. La recuperación sin gobernanza puede mejorar un benchmark y ampliar la superficie de exposición.
Un contrato mínimo para esta memoria incluye:
| campo | Pregunta de control |
|---|---|
source | ¿De dónde proviene el caso y qué uso está permitido? |
risk_class | ¿Qué propiedad de seguridad representa? |
affected_surface | ¿Qué lenguaje, biblioteca, herramienta o modelo está dentro del alcance? |
observed_at | ¿Cuándo se observó el fallo? |
evidence | ¿Qué artifact permite reconstruir el finding? |
review_after | ¿Cuándo debe revalidarse el caso? |
access_policy | ¿Quién puede recuperar el contenido y con qué finalidad? |
La recuperación también debe registrar qué ejemplos influyeron en la decisión. Sin ello, una constitución generada es una explicación plausible, no una traza reproducible.
La validación dinámica no es ejecutar código libremente
El beneficio del análisis dinámico tiene una condición: el código potencialmente hostil debe ejecutarse dentro de una frontera diseñada para fallar de forma segura. Red denegada por defecto, sistema de archivos efímero, ausencia de credenciales útiles, límites de CPU y memoria, timeout, imagen pinada, registro externo y descarte verificable son requisitos del harness, no detalles de implementación.
El propio repositorio usa Docker para la tarea de vulnerabilidad. Esto es evidencia de una implementación de investigación, no una certificación de aislamiento. Un contenedor no debe tratarse como sinónimo de una sandbox suficiente para cualquier adversario. La organización debe modelar amenazas, probar escapes relevantes y definir qué ocurre cuando el verificador se bloquea, diverge o no puede ejecutar el caso.
Un gate técnico para revisión de código por IA
Antes de permitir que un revisor de IA influya en un merge o release, el equipo puede exigir:
- ¿El finding identifica archivo, línea, propiedad vulnerada y evidencia reproducible?
- ¿El clasificador se midió en el tipo de código, lenguaje y distribución relevantes?
- ¿Falso positivo, falso negativo e inconcluso son estados separados?
- ¿Las pruebas dinámicas se ejecutan fuera del entorno de desarrollo y sin credenciales útiles?
- ¿La base adversarial tiene provenance, licencia, validez, control de acceso y versionado?
- ¿El artifact evaluado está vinculado al commit y al digest que se promoverá?
- ¿Las reglas protegidas impiden que el propio agente omita checks o altere el gate?
- ¿Una persona accountable aprueba el riesgo residual de forma proporcional a la consecuencia?
El output útil no es ‘seguro’. Es un paquete compuesto por el finding, evidencia, limitaciones, versiones de componentes, resultado de las pruebas y decisión de autoridad.
Lo que prueba el paper — y lo que no prueba
El paper aporta evidencia experimental de que la combinación propuesta superó los baselines estudiados en los benchmarks reportados. El el código y parte de los datos son públicos, lo que mejora la posibilidad de inspección y reproducción. Los subconjuntos de código malicioso permanecen bajo acceso controlado, de acuerdo con las licencias y el impacto descritos por los autores.
Esto no equivale a una replicación independiente completa. El estudio no mide operación continua en repositorios empresariales, latencia y coste a escala, impacto sobre desarrolladores, resistencia a una adaptación adversarial prolongada, cobertura de lenguajes reales ni reducción de incidentes después del deploy.
Tampoco autoriza convertir el 14,7% en una promesa comercial. La métrica es una media en condiciones experimentales con GPT-4o como base. Otro modelo, otra base de riesgo, otro balanceo u otra política de decisión puede producir un resultado diferente.
Limitaciones, contrapuntos y conflictos
- El paper y el repositorio fueron producidos por los autores del método; en el corte del 01/10/2026 no se localizó una reproducción completa e independiente de los resultados finales.
- La base usa conocimiento derivado de red teaming; su rendimiento depende de la proximidad entre los riesgos recuperados y los casos evaluados.
- El análisis dinámico aparece específicamente en la tarea de código vulnerable, no como mecanismo universal para las cuatro tareas.
- La publicación del repositorio mejora la auditabilidad, pero parte de los datos maliciosos está restringida y la reproducción integral exige modelos, claves, Docker y condiciones compatibles.
- La página de Microsoft Research y los proceedings finales difieren en tareas y mejora media; en esta versión prevalece el registro final de la conferencia.
- Los controles de este brief son una propuesta profesional derivada de las evidencias, no resultados causales medidos por el paper.
Fuentes directas
- PMLR — BlueCodeAgent: A Blue Teaming Agent Powered by Automated Red Teaming for CodeGen AI. Registro final en los Proceedings of the 43rd ICML, cuatro tareas y una mejora media del 14,7% en F1 con GPT-4o.
- Repositorio oficial de BlueCodeAgent. Implementación, estructura de datos, scripts de evaluación, sandbox y límites de acceso a los subconjuntos maliciosos.
- Microsoft Research — BlueCodeAgent. Página institucional que todavía presenta 12,7% y tres tareas; se conserva como registro de la divergencia de versión.
Nota editorial y de responsabilidad
Este texto combina hechos atribuidos a las fuentes con el análisis y la propuesta técnica del autor. Los puntos de vista personales y profesionales no son hechos probados; se indican datos, denominadores, límites y conflictos cuando están disponibles. El contenido es informativo y no sustituye una evaluación técnica, jurídica, financiera o de seguridad. Tech Human y Trustyu operan comercialmente en áreas relacionadas. La investigación, estructura y redacción contaron con asistencia de IA; Fernando Parreiras confirmó la revisión factual, la aprobación autoral y la publicación el 01/10/2026, sin revisión humana independiente adicional.
Corte de la investigación: 01/10/2026. Estado editorial: Evidence Brief especial autorizado para el 02/10/2026 a las 13:30 BRT.
Nota editorial y de responsabilidad
- Corte de la investigación
- Última revisión
- Correcciones registradas
- No hay correcciones registradas.
El corte anterior corresponde a los claims canónicos. Las fuentes complementarias y sus fechas de consulta se identifican en el cuerpo del artículo.
Este artículo combina fuentes citadas, análisis y experiencia profesional del autor. Los datos verificables y las afirmaciones fácticas están vinculados a sus respectivas fuentes. Las interpretaciones, hipótesis, proyecciones, recomendaciones y opiniones representan el punto de vista profesional del autor en el momento de la publicación; no constituyen hechos probados, promesas de resultados ni asesoramiento jurídico, financiero o técnico aplicable a un caso concreto. Consulte las fuentes originales y a profesionales cualificados antes de tomar decisiones.
Claims y fuentes
BLUECODE-C1
En los proceedings finales de ICML, BlueCodeAgent con GPT-4o reporta una mejora media del 14.7% en F1 en cuatro tareas de benchmark frente al prompting directo, combinando conocimiento recuperado de red teaming con resumen de constituciones y análisis dinámico para la tarea de código vulnerable.
Límite: La cifra del 14.7% es una mejora media en F1 reportada en los proceedings finales de ICML para GPT-4o en cuatro tareas de benchmark frente al prompting directo. No es una tasa de incidentes en producción, un ranking universal de modelos, una replicación independiente ni prueba de que el sistema evite código inseguro en repositorios reales.
- BlueCodeAgent: A Blue Teaming Agent Powered by Automated Red Teaming for CodeGen AI — Proceedings of Machine Learning Research, términos de publicación de PMLR; síntesis bibliográfica y del resumen
- Implementación oficial de BlueCodeAgent — Autores de BlueCodeAgent, MIT para el código; se aplican términos específicos de los datasets y subconjuntos con acceso controlado