Lectura ejecutiva · ~60 segundos
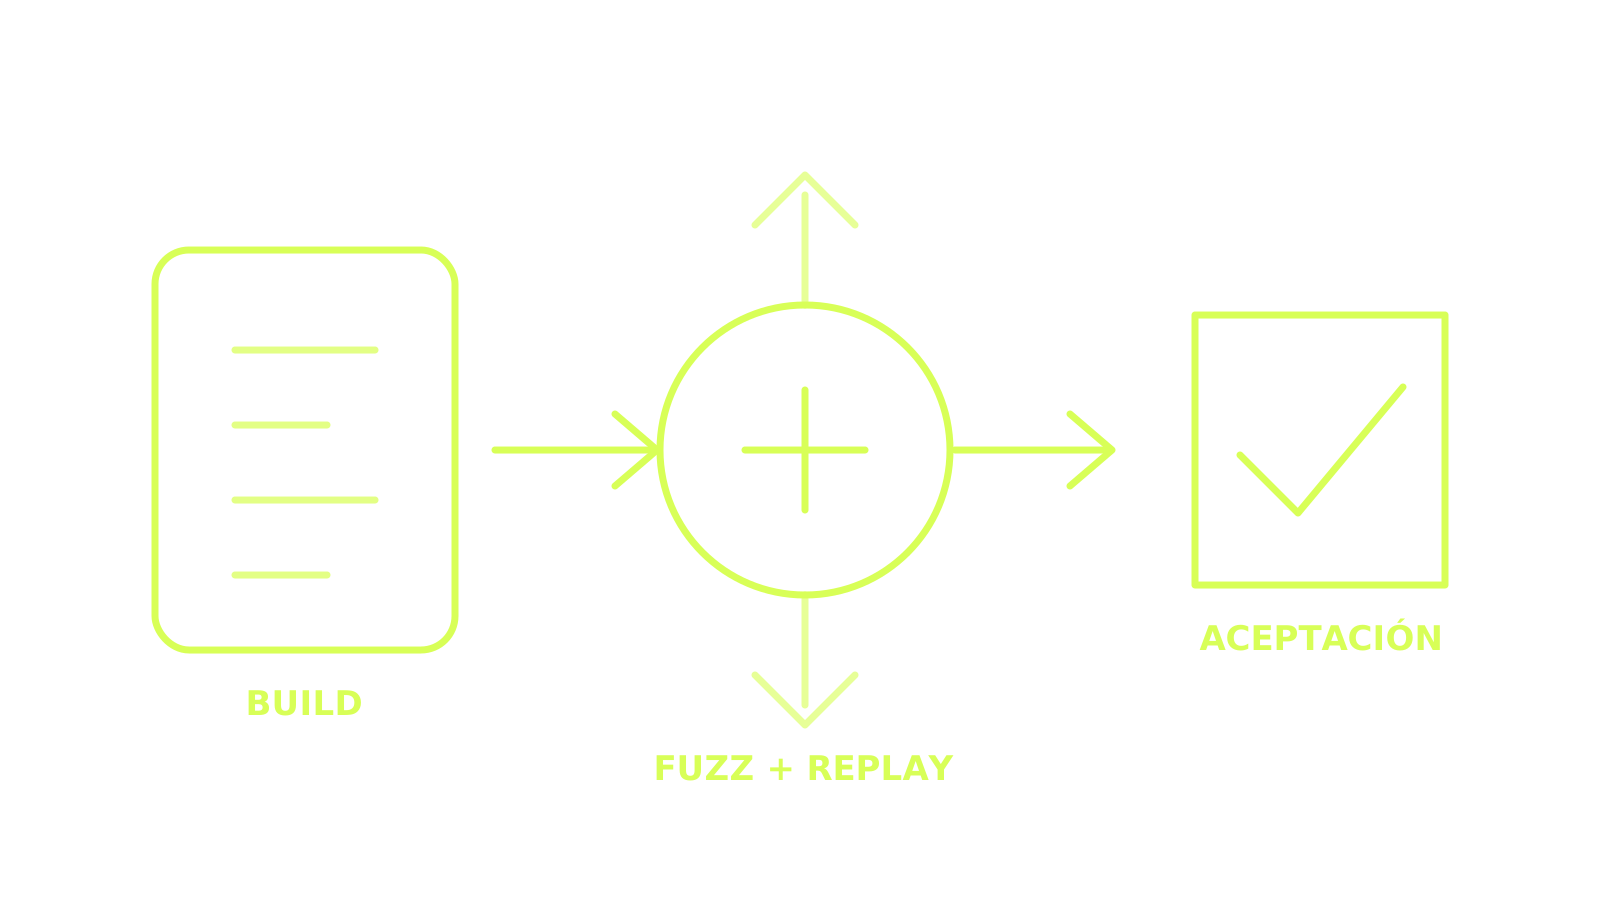
En SolBehave, la compilación varió del 26,4 % al 92,7 %, pero solo el 31,4 % de los cuerpos de función compilados fueron equivalentes en el fuzzing diferencial agregado. Un build válido debe separarse del comportamiento, la seguridad y la aceptación.
Un contrato puede compilar, exponer las funciones esperadas y aun así ejecutar reglas distintas del original. En finanzas programables, esa diferencia no es un detalle de implementación: puede alterar saldos, permisos, oferta, eventos, reverts o secuencias válidas de transacciones.
Estado: Evidence Brief aprobado para publicación. Serie editorial: Papers que leemos por ti. Este texto analiza el preprint *SolBehave: A Behavioral Benchmark for LLM-Generated Smart Contracts*. No afirma que Trustyu Forge haya reproducido los experimentos, que la equivalencia en los oráculos evaluados demuestre corrección universal ni que los porcentajes se transfieran a otro modelo, prompt o dominio.
Qué mide SolBehave
Los autores partieron de 8.360 contratos Ethereum verificados. Lograron reproducir 2.098 y seleccionaron 250 contratos no proxy, con entre una y veinte funciones no triviales; la mediana informada fue de 16 funciones por contrato. El recorte favorece contratos token-like y deja fuera sistemas mayores, proxies y una parte relevante de la complejidad encontrada en producción.
Siete modelos open-weight recibieron la tarea de regenerar el contrato. Cada combinación tuvo diez generaciones y una ronda de autorreparación, con cuantización de 4 bits y configuración uniforme. La comparación separó el éxito de compilación de la equivalencia observable.
La compilación varió del 26,4 % al 92,7 %
La tasa de compilación quedó entre el 26,4 % y el 92,7 %, según el modelo. Esta diferencia ya muestra que producir un artefacto sintácticamente aceptado sigue siendo sensible a la capacidad y a la configuración. Sin embargo, el dato más importante aparece después del build: en el agregado, solo el 31,4 % de los cuerpos de función compilados fueron clasificados como equivalentes en el fuzzing diferencial.
La compilación responde si el artefacto cumple una gramática, tipos y reglas estáticas del toolchain. No responde si la transición de estado, la autorización o los efectos observables permanecen iguales.
Tres oráculos buscaron divergencias
El benchmark combinó tres formas de observación:
- Fuzzing diferencial: ejecuta entradas en los contratos original y regenerado y compara salidas, estado, eventos y fallos observables.
- Replay histórico: reaplica transacciones reales conocidas, con 1.000 transacciones por contrato en el experimento descrito.
- Replay sintético guiado por dependencias: crea secuencias a partir de relaciones de lectura y escritura entre funciones, buscando estados que las llamadas aisladas no alcanzan.
En seis de los siete modelos, entre el 13 % y el 31 % de los contratos divergieron en el replay histórico. En el replay sintético guiado por dependencias, el intervalo fue del 13 % al 44 %. Gemma-4-31B quedó por debajo del 3 % en los dos replays informados. Este resultado es específico de la configuración y no demuestra superioridad general, ausencia de fallos ni seguridad del código generado.
La equivalencia observada no es seguridad demostrada
Un contrato puede coincidir en todas las entradas ejecutadas y aun así divergir en una secuencia no generada. También puede reproducir fielmente un comportamiento inseguro del original. Por eso, los oráculos de SolBehave añaden evidencia, pero no sustituyen especificación, análisis de acceso, invariantes, auditoría de seguridad ni revisión de cambios económicos.
El replay guiado por dependencias ayuda a alcanzar estados compuestos, pero puede perder caminos que aceptan transacciones inválidas o dependen de relaciones no capturadas. Comparar estado, retorno y almacenamiento es una aproximación observacional, no una prueba formal de equivalencia.
Un contrato mínimo para generación y aceptación
- Fuente y derechos: registre el contrato observado, la versión, la licencia o autorización y el propósito de la reimplementación.
- Especificación: declare invariantes de saldo, oferta, acceso, eventos, fallos y transiciones antes de aceptar el código.
- Build reproducible: fije compilador, dependencias, optimizaciones, red y parámetros.
- Oráculos independientes: combine pruebas de propiedades, fuzzing diferencial, replay histórico y secuencias adversarias.
- Separación: no permita que la misma trayectoria genere la implementación y decida por sí sola si es equivalente.
- Receipts: preserve modelo, prompt, artefacto, bytecode, seeds, transacciones, divergencias y decisión humana.
- Promoción gradual: mantenga límites de valor, privilegios mínimos, pausa y rollback proporcionales al impacto.
regla de arquitectura
El receipt “compiló” demuestra solo una etapa. La promoción exige una cadena que conecte intención, invariantes, build reproducible, comportamiento diferencial, seguridad y aceptación humana. Cuando el software mueve activos o ejecuta reglas irreversibles, la ausencia de esa cadena es una deuda de evidencia, no solo una brecha de pruebas. [R2-C3]
En Forge, el harness debe impedir que una única señal —compilación, prueba verde o similitud textual— sea promovida a prueba total. Las evidencias complementarias deben seguir siendo identificables, con límites y responsables propios.
Límites y conflicto de interés
El paper es un preprint enviado al IEEE. La muestra final contiene 250 contratos, deriva de un embudo de 8.360 candidatos y favorece contratos token-like con hasta 20 funciones. Las ejecuciones comienzan desde un estado nuevo, lo que no representa toda migración ni historial de producción. Siete modelos open-weight, una configuración uniforme y una ronda de autorreparación no cubren todos los agentes, toolchains o estrategias posibles.
La validación manual de dependencias fue realizada por un único especialista en 30 contratos y 200 relaciones, lo que limita la estimación de error de este componente. Hasta el cierre editorial, no encontramos una reproducción independiente completa ni una respuesta pública específica de los proveedores. Los autores declaran afiliaciones con la University of Bologna y la University of Copenhagen; no encontramos conflicto comercial con proveedores de modelos. La ausencia de un conflicto identificado no demuestra independencia absoluta.
Fuentes directas
- SolBehave: A Behavioral Benchmark for LLM-Generated Smart Contracts — arXiv. Preprint, autores, resumen, versión y fecha.
- SolBehave — texto completo. Método, embudo de la muestra, configuraciones, oráculos, resultados y limitaciones.
Nota editorial y de responsabilidad
Este texto combina hechos atribuidos a las fuentes con el análisis y la propuesta técnica del autor. Los puntos de vista personales y profesionales no son hechos demostrados; los datos, denominadores, límites, afiliaciones y la ausencia de reproducción independiente se indican cuando están disponibles. El contenido es informativo y no sustituye una evaluación técnica, jurídica, financiera o de seguridad. Ethereum, los contratos, productos y modelos citados pertenecen a sus respectivos titulares; no existe patrocinio ni respaldo. Tech Human y Trustyu operan comercialmente en desarrollo y gobernanza de productos digitales. La investigación, estructura y redacción contaron con asistencia de IA; la revisión factual, la aprobación autoral y la publicación fueron autorizadas por Fernando Parreiras el 14/10/2026, sin revisión humana independiente adicional.
Cierre de la investigación: 14/10/2026. Estado editorial: Evidence Brief especial autorizado para el 27/10/2026 a las 09:00 BRT.
Nota editorial y de responsabilidad
- Corte de la investigación
- Última revisión
- Correcciones registradas
- No hay correcciones registradas.
El corte anterior corresponde a los claims canónicos. Las fuentes complementarias y sus fechas de consulta se identifican en el cuerpo del artículo.
Este artículo combina fuentes citadas, análisis y experiencia profesional del autor. Los datos verificables y las afirmaciones fácticas están vinculados a sus respectivas fuentes. Las interpretaciones, hipótesis, proyecciones, recomendaciones y opiniones representan el punto de vista profesional del autor en el momento de la publicación; no constituyen hechos probados, promesas de resultados ni asesoramiento jurídico, financiero o técnico aplicable a un caso concreto. Consulte las fuentes originales y a profesionales cualificados antes de tomar decisiones.
Claims y fuentes
R2-C3
Los privilegios mínimos, la ejecución aislada y la provenance de la cadena de suministro son controles complementarios; no hay sustitutos para los demás en un sistema agente.
Límite: El perfil de control exacto sigue siendo específico del entorno y debe modelarse en función de las amenazas para cada producto. Este es un insumo de diseño de investigación-síntesis; no prueba la adopción del producto, la madurez operativa, la attestation independiente o el resultado.
- OpenAI — OpenAI, repositorio Apache-2.0; extractos de solo análisis
- OWASP Fundación — OWASP Fundación, estándar CC-BY-SA-4.0; extractos de solo análisis
- OpenSSF SLSA — OpenSSF SLSA, CC-BY-4.0 especificación; extractos de solo análisis