Lectura ejecutiva · ~60 segundos
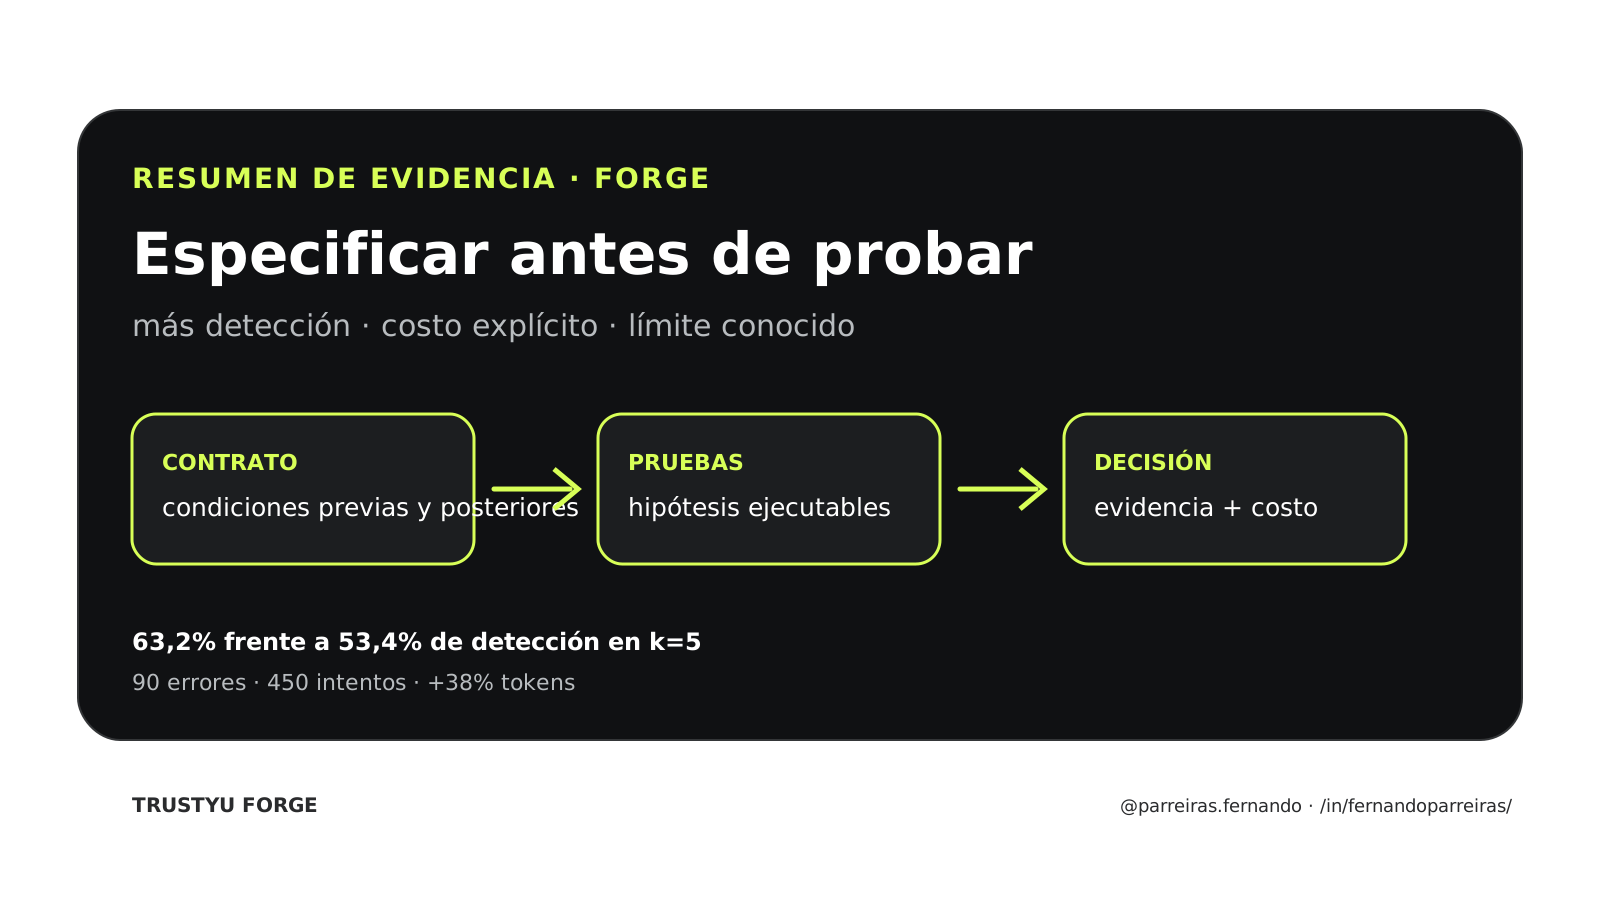
En 90 errores de producción históricos de Google, un agente que redactó contratos antes de generar las pruebas detectó el 63,2% de los defectos en cinco intentos, en comparación con el 53,4% en la línea de base. La ganancia de 9,8 puntos porcentuales se produjo con un 38% más de tokens. El estudio sustenta los contratos como una etapa útil de razonamiento y control, no como un sustituto de la cobertura, revisión o decisión humana.
Un agente puede generar muchas pruebas y aun así no tocar la propiedad que distingue el comportamiento correcto de un defecto. El problema no es sólo escribir código de prueba. Se trata de hacer explícito el contrato que el sistema debe preservar antes de elegir entradas y oráculos.
Estado: Resumen de evidencia aprobado para publicación. Este texto analiza un estudio con errores históricos internos de Google. No afirma que Trustyu Forge haya reproducido los experimentos ni que los resultados se transfieran automáticamente a otra pila, modelo u organización.
el experimento
El artículo *Grounding AI Agents in Contracts* evaluó 90 errores de producción históricos, todos con correcciones en un solo archivo, en C++, Java, Python y Go. El mismo modelo, Gemini 3 Flash, recibió hasta cinco intentos por error, con un total de 450 ejecuciones por enfoque. Al inicio, el agente generó pruebas directamente. En la condición basada en especificaciones, primero escribí condiciones previas, condiciones posteriores y sugerencias de prueba en lenguaje natural; Luego utilizó este contrato para producir la suite.
La curación humana opcional propuesta por la arquitectura fue eliminada deliberadamente del experimento. Esto le permite medir la contribución de la etapa de especificación, pero no mide un flujo de ingeniería completo con expertos revisando el contrato.
La ganancia, con denominador.
En cinco intentos, el enfoque basado en contratos detectó el 63,2% de los 90 errores, en comparación con el 53,4% en la línea de base, una diferencia de 9,8 puntos porcentuales, reportada con p=0,0352. Se encontraron 57 errores con el enfoque basado en especificaciones y 48 con la línea base: 45 en común, 12 exclusivos de la especificación y tres exclusivos de la línea base.
La cobertura de sucursales aumentó del 46,4% al 48,9%, una diferencia de 2,5 puntos; la variación en la cobertura de línea fue de -0,4 puntos y no fue estadísticamente significativa. Esto es importante porque una mayor detección no se produjo simplemente al ejecutar muchas más líneas. El contrato parece haber guiado qué comportamientos buscar.
Cuando la suite cubrió el contrato producido, la detección ocurrió en el 54,9% de los intentos, 151 de 275. Sin la cobertura del contrato, ocurrió en el 19,4%, 34 de 175. Es una fuerte asociación dentro del experimento, no una prueba causal universal.
El coste que no se debe ocultar
La línea de base consumió 243,9 millones de tokens. El enfoque basado en especificaciones consumió 336,7 millones: un 38% más. Las entradas crecieron un 36,2% y las salidas un 59,1%. Debido al error exclusivo encontrado, el costo estimado aumentó de 5,1 millones a 5,9 millones de tokens, un aumento del 16,2%.
Este número cambia la decisión operativa. Una mejor detección puede justificar una mayor inferencia sobre el software crítico, pero no sobre ningún cambio. La política debe definir cuándo el contrato adicional es obligatorio, cuándo es suficiente una plantilla más sencilla y cuándo el coste no es pagadero.
Cómo convertir el hallazgo en un gate
- Declarar propiedad: registre condiciones previas, condiciones posteriores, invariantes y comportamientos prohibidos antes de ordenar pruebas.
- Contrato de implementación separado: el oráculo debe observar el comportamiento, no copiar la solución conocida.
- Medir la cobertura del contrato: La cobertura de líneas y sucursales sigue siendo útil, pero no informa por sí sola si se ha ejercido la propiedad crítica.
- Preservar la divergencia: Si las pruebas directas y las pruebas basadas en contratos encuentran diferentes conjuntos de errores, utilice la diversidad en lugar de elegir un solo agente.
- Presupuesta la inferencia: tokens de registro, latencia y costo por defecto adicional detectado.
- Enlace al artefacto: contrato, suite, resultado, modelo, prompt y commit deben formar una traza reproducible.
- Mantener la decisión humana: una prueba fallida es evidencia para investigar; una prueba aprobada no certifica todo el sistema.
Lo que el estudio no prueba
La muestra proviene de un único monorepo y un proceso interno Google. Los errores son históricos, la solución afecta a un archivo y el experimento utiliza una familia de modelos. Los sistemas distribuidos, los fallos de configuración, la identidad, la concurrencia, las dependencias y los incidentes emergentes pueden responder de forma diferente.
La evaluación de la calidad de la suite también utilizó a Gemini 3.1 Pro como juez. El estudio anonimizó y aleatorizó el orden y repitió la prueba cinco veces, pero un evaluador de LLM puede tener ruido, preferencia de estilo o afinidad con la misma familia de tecnología. La preferencia del 77,8% sobre la línea de base y del 56,7% sobre las pruebas en humanos, entre 83 pruebas generadas con éxito, no equivale a una superioridad general sobre los expertos.
Todos los autores están vinculados a Google. Esto no invalida el trabajo, pero hace que la afiliación, el acceso al conjunto de datos internos y la falta de reproducción independiente sean relevantes para la lectura. Hasta el corte del 04/10/2026, no encontramos una replicación externa del experimento completo.
regla de arquitectura
La especificación no es documentación escrita posteriormente. Es un intermediario verificable entre la intención y la ejecución. Cuando un agente necesita declarar el contrato antes de realizar la prueba, el equipo obtiene un objeto que puede revisar, versionar, comparar y usar para explicar por qué esa suite debería detectar una determinada clase de error. [HARNESS31-C2]
El resultado útil no es “la IA probada”. Se trata de: qué dominio se declaró, qué pruebas lo ejercieron, qué costo se consumió, qué quedó fuera del alcance y quién autorizó el riesgo residual.
Fuentes directas
- Poner a tierra a los agentes de IA en los contratos: una evaluación empírica de la generación de pruebas basada en especificaciones - arXiv. Preimpresión, método, muestra, tablas y limitaciones.
- DOI ACM del artículo. Registro persistente de la publicación.
Nota editorial y de responsabilidad
Este texto combina hechos atribuidos a las fuentes con el análisis y propuesta técnica del autor. Las opiniones personales y profesionales no son hechos probados; Los datos, denominadores, límites y conflictos se indican cuando están disponibles. El contenido es informativo y no sustituye a la valoración técnica, jurídica, financiera o de seguridad. Tech Human y Trustyu trabajan comercialmente en temas relacionados. La investigación, la estructura y la redacción contaron con la ayuda de la IA; La revisión de los hechos, la aprobación del autor y la publicación fueron confirmadas por Fernando Parreiras el 4/10/2026, sin revisión humana independiente adicional.
Corte de investigación: 04/10/2026. Estado editorial: Resumen de evidencia especial autorizado para el 6/10/2026 a las 9 a.m. BRT.
Nota editorial y de responsabilidad
- Corte de la investigación
- Última revisión
- Correcciones registradas
- No hay correcciones registradas.
El corte anterior corresponde a los claims canónicos. Las fuentes complementarias y sus fechas de consulta se identifican en el cuerpo del artículo.
Este artículo combina fuentes citadas, análisis y experiencia profesional del autor. Los datos verificables y las afirmaciones fácticas están vinculados a sus respectivas fuentes. Las interpretaciones, hipótesis, proyecciones, recomendaciones y opiniones representan el punto de vista profesional del autor en el momento de la publicación; no constituyen hechos probados, promesas de resultados ni asesoramiento jurídico, financiero o técnico aplicable a un caso concreto. Consulte las fuentes originales y a profesionales cualificados antes de tomar decisiones.
Claims y fuentes
HARNESS31-C2
Un harness duradero debe mantener el historial de sesiones, la política de orquestación y el aislamiento de ejecución como límites explícitos, mientras que los adaptadores y complementos evitan que la elección del modelo o canal se convierta en el límite de seguridad.
Límite: Las fuentes muestran dos implementaciones, no un estándar de interoperabilidad neutral. Los permisos reales deben aplicarse y probarse de forma independiente fuera de las opciones del modelo. Este es un input de diseño source-bound; no prueba la adopción del producto, la madurez operativa, la attestation independiente, la clasificación de búsqueda, la citación de IA o el resultado.
- Anthropic — Anthropic, términos de sitio propietario
- Software YC —Software YC, MIT
- Software YC —Software YC, MIT