
Lectura ejecutiva · ~60 segundos
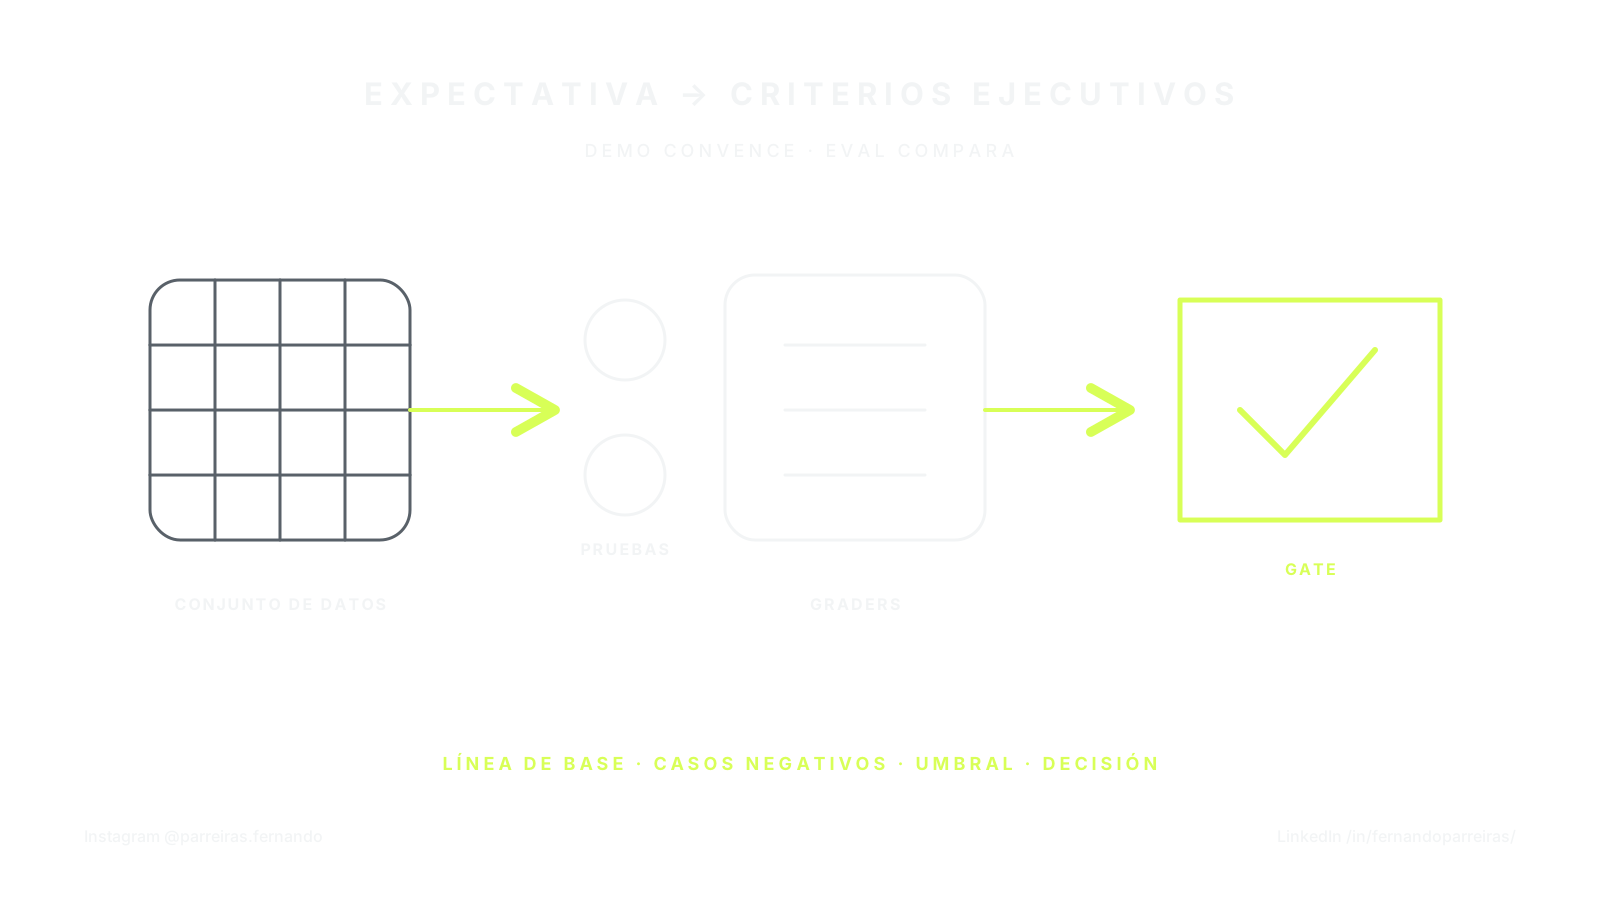
Evals transforma las expectativas en tareas, graders, trials y gates, reduciendo la dependencia de demostraciones y la impresión subjetiva.
“El agente mejoró” es un sentimiento. “El agente resolvió 18 de 20 casos críticos, conservó los cinco negativos y no creó efectos prohibidos” es una afirmación que puede orientar a un release.
Evals transforma las expectativas del producto en tareas, graders, trials y resultados observables. No eliminan la incertidumbre, pero evitan que cada cambio se base únicamente en la memoria, la demostración o la confianza en el modelo más nuevo.
Resumen ejecutivo
Inicie evals antes de automatizar todo el flujo.
| Elemento | Contrato mínimo |
|---|---|
| tarea | entrada y entorno reproducibles |
| éxito | Estado final y comportamiento esperado. |
| grader | regla que verifica una propiedad |
| trial | una ejecución grabada |
| dataset | Casos positivos, negativos y fronterizos. |
| baseline | rendimiento de la versión actual |
| gate | decisión vinculada al resultado |
| revisión | Lectura traces y calibración humana |
Una puntuación no es calidad total. Es evidencia sobre propiedades definidas.
Comience con el producto, no con la métrica
Antes de elegir el marco, escriba:
- quién utiliza el agente;
- qué resultado esperas;
- ese fracaso es inaceptable;
- ese comportamiento es subjetivo;
- qué estado del medio ambiente prueba la conclusión;
- qué variación es tolerable;
- cuya decisión lanza el eval.
Si dos personas del dominio no están de acuerdo sobre lo que debería pasar, el problema todavía está en la especificación.
El éxito de la tarea no es una sola variable
Un agente puede dar la respuesta correcta e infringir policy. Es posible que sigas policy y no completes la acción. Puede completar y crear retrabajos más tarde.
Dimensiones separadas:
| Dimensión | Ejemplo de verificación |
|---|---|
| outcome | registro realmente creado o error realmente solucionado |
| calidad | criterio de dominio o rúbrica calibrada |
| seguridad | la acción prohibida falla |
| eficiencia | pasos, tiempo y costo dentro del budget |
| interacción | claridad, escalamiento y solicitud de información |
| evidencia | trace y artefactos asignables |
gate puede requerir todas las dimensiones críticas, no un promedio que compense los fallos de seguridad con una buena escritura.
Elija grader por propiedad
Código
Utilice prueba, esquema, consulta, pelusa o inspección de estado cuando la propiedad sea objetiva.
Modelo
Utilice rúbrica para aspectos sin verificador determinista, con ejemplos y calibración humana. A un juez no se le debe dar mayor autoridad que la evidencia que presenta.
Persona
Utilice expertos cuando el contexto, el impacto o la subjetividad requieran juicio. La revisión humana también calibra el graders automático.
Combinar capas es más sólido que esperar un corrector universal.
Dataset nace del trabajo real
Una primera suite puede proceder de:
- tareas manuales frecuentes;
- incidentes y errores;
- tickets de soporte;
- casos que el equipo siempre demuestra;
- aportes contradictorios;
- decisiones donde el agente debe escalar;
- casos en los que el no debería utilizar una herramienta.
No utilices sólo ejemplos felices. Una suite unilateral enseña al sistema a hacer siempre lo que debería hacer sólo algunas veces.
Capability y la regresión miden cosas diferentes
- capability eval: ¿Qué es lo que todavía no hemos podido hacer lo suficiente?
- regresión eval: ¿Qué ya estaba funcionando y no puede empeorar?
Cuando un capability madura, sus casos estables pueden migrar a la regresión. release necesita proteger ambas direcciones: mejorar la frontera sin perder terreno.
No ocultes el no determinismo
Un intento exitoso no demuestra coherencia. Rotar trials proporcional al riesgo y diferenciar:
- probabilidad de lograr al menos un éxito en varios intentos;
- posibilidades de repetir el éxito en todos los intentos;
- variación de costos, pasos y resultado.
Una herramienta de exploración puede aceptar múltiples intentos. Un agente que realiza efectos financieros puede necesitar una coherencia mucho mayor y gate.
Las fuentes de rastreo y eval elegibles respaldan que baseline, el resultado y la observabilidad deben calibrarse por caso de uso; no definen umbrales FORGE universales. [R3-C1]
eval también podría estar equivocado
Lea traces y busque:
- tarea ambigua;
- referencia imposible;
- grader que penaliza la solución válida;
- fuga de respuesta en contexto;
- dataset contaminado;
- diferente distribución de la producción;
- puntuación saturada;
- estímulo para explorar lagunas jurídicas;
- mejora de la puntuación con empeoramiento de outcome.
Un eval es una hipótesis de software y producto. Necesita propiedad, control de versiones y mantenimiento.
Un simple gate de release
1. regressões críticas = 0
2. casos de segurança negativos = 100% bloqueados
3. capability alvo melhora sobre baseline
4. custo e latência dentro do budget
5. traces amostrados sem falha material nova
6. reviewer aceita os limites
Las cifras anteriores son marcos, no umbrales universales. Cada producto define riesgo y tolerancia.
Evals no reemplaza la producción
Pre-release prueba escenarios conocidos. La producción revela distribución real, cambios de comportamiento, integraciones y efectos que dataset no anticipó.
Combinar:
- evals fuera de línea;
- monitoreo y traces;
- comentarios de los usuarios;
- pruebas controladas cuando hay tráfico y base;
- revisión periódica de casos;
- incidentes convertidos en regresión.
Si un incidente no cambia la suite o el control, el sistema puede repetir la falla de otra manera.
Evals acelera el cambio de modelo
Sin una suite, un nuevo modelo reinicia la discusión a través de demostraciones. Con suite, el equipo compara en su propio contexto:
- éxito por clase de tarea;
- consistencia;
- costo total;
- estado latente;
- nuevos fracasos;
- comportamiento de seguridad;
- necesidad de andamios.
La tabla de clasificación informa la posibilidad. La suite interna informa de idoneidad.
Lo que este artículo prueba y lo que no prueba
Fuentes oficiales y prácticas públicas respaldan tareas, trials, graders, traces y combinación de señales. No prueban que el eval automatizado represente todo el valor del producto, ni que el juez LLM sea independiente por definición.
Este artículo ofrece un diseño minimalista. La validez depende del dataset, el entorno, los revisores y la decisión vinculada a la puntuación.
Conclusión
Evals hace que las expectativas sean discutibles antes de release. Transforman lo que “se ve mejor” en casos, propiedades, resultados y límites que el equipo puede revisar.
El objetivo no es producir un número bonito. Es saber qué ha cambiado, qué ha quedado protegido y qué riesgo aún no se ha medido.
Lectura anterior: El agente no puede ser su propio auditor. Siguiente lectura sugerida: Design Partner no es un mercado.
Nota editorial y de responsabilidad
- Corte de la investigación
- Última revisión
- Correcciones registradas
- No hay correcciones registradas.
El corte anterior corresponde a los claims canónicos. Las fuentes complementarias y sus fechas de consulta se identifican en el cuerpo del artículo.
Este artículo combina fuentes citadas, análisis y experiencia profesional del autor. Los datos verificables y las afirmaciones fácticas están vinculados a sus respectivas fuentes. Las interpretaciones, hipótesis, proyecciones, recomendaciones y opiniones representan el punto de vista profesional del autor en el momento de la publicación; no constituyen hechos probados, promesas de resultados ni asesoramiento jurídico, financiero o técnico aplicable a un caso concreto. Consulte las fuentes originales y a profesionales cualificados antes de tomar decisiones.
Claims y fuentes
R3-C1
Un claim de calidad de la IA requiere criterios de evaluación explícitos y evidencia de ejecución observable; las trazas por sí solas y la inspección subjetiva por sí sola son incompletas.
Límite: Ninguna fuente define umbrales de aprobación específicos de FORGE; Las líneas de base deben calibrarse por caso de uso. Este es un insumo de diseño de investigación-síntesis; no prueba la adopción del producto, la madurez operativa, la attestation independiente o el resultado.