Lectura ejecutiva · ~60 segundos
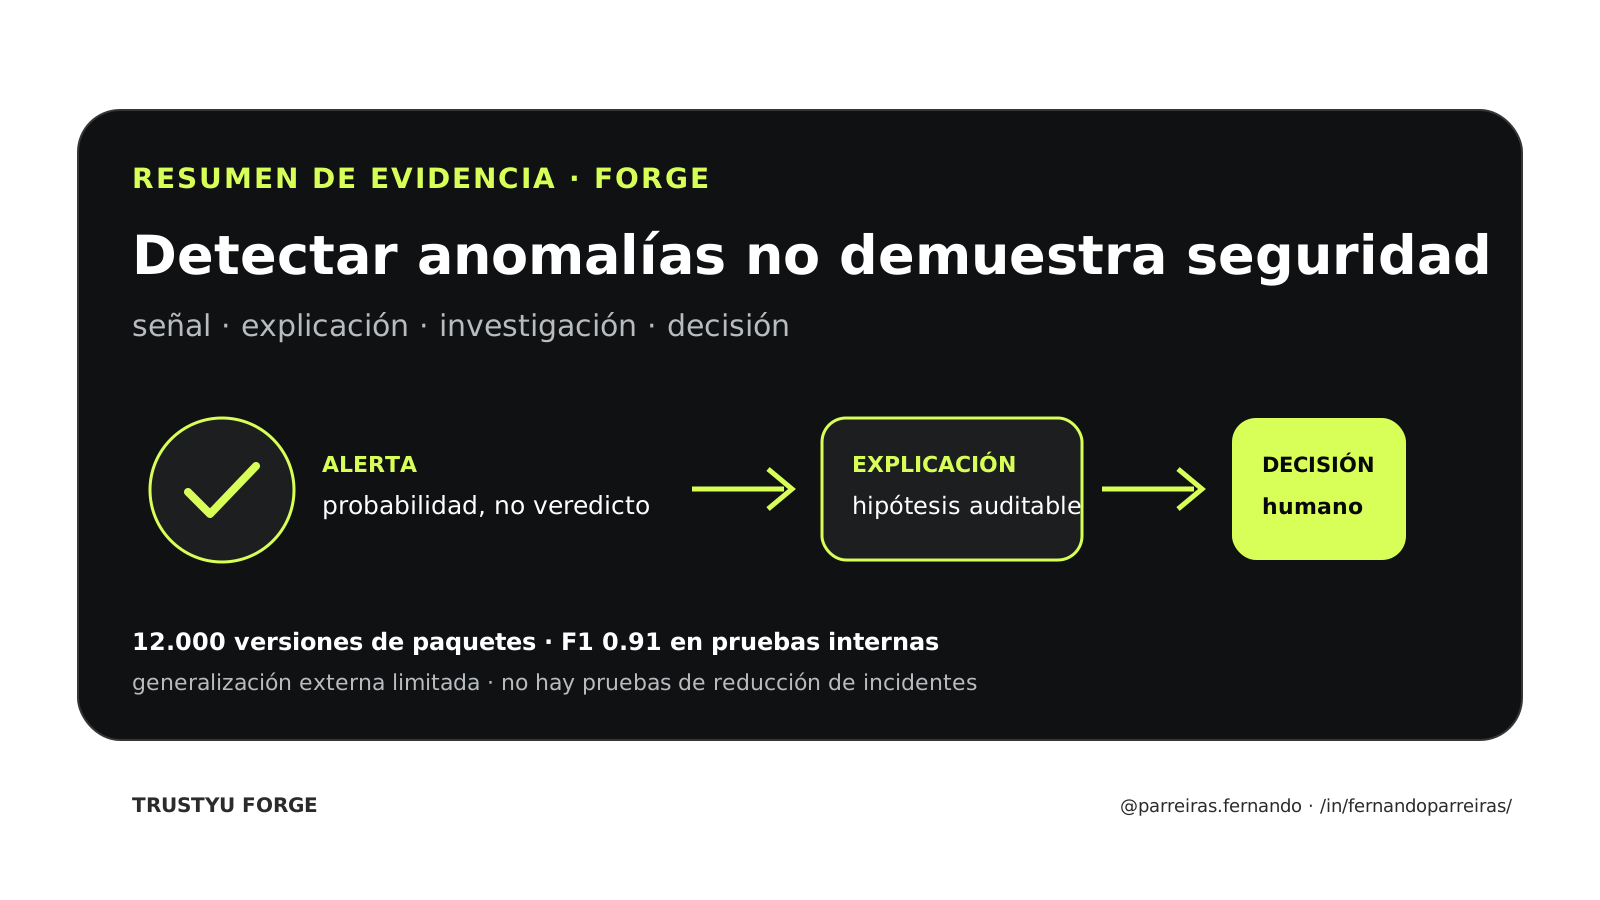
XAI-SCS reporta un F1 de 0,91 en una prueba interna con versiones de paquetes npm y PyPI y combina detección con explicaciones. La investigación muestra una vía útil para priorizar la investigación, pero no demuestra una reducción de incidentes en producción ni convierte la explicación en prueba causal. El control maduro trata el modelo como sensor, preserva el origen de las señales y mantiene la autoridad humana sobre el bloqueo y el release.
La cadena de software crece más rápido que la capacidad humana para inspeccionar cada versión de cada dependencia. Un detector puede ayudarle a priorizar qué investigar. El riesgo comienza cuando su puntuación se convierte en un veredicto y su explicación plausible se convierte en prueba de que el paquete es malicioso o seguro.
Estado: Resumen de evidencia aprobado para publicación. Este texto analiza un artículo de *Scientific Reports*. No afirma que Trustyu Forge haya reproducido los resultados, implementado el método o validado su efectividad en entornos de producción.
Lo que propone XAI-SCS
El artículo presenta una arquitectura híbrida con CNN, LSTM y codificador automático para analizar señales de las versiones de paquetes npm y PyPI. La capa de IA explicable busca mostrar qué características contribuyeron a una alerta, lo que permite al practicante investigar la hipótesis en lugar de simplemente recibir una puntuación opaca.
El conjunto de datos reúne 12.000 versiones de paquetes. Las etiquetas derivan principalmente de CVE y de intoxicaciones simuladas con GAN. En pruebas internas separadas, los autores reportan un F1 de 0,91; en cinco corridas, el promedio fue de 0,90 con una desviación de 0,02. La latencia promedio reportada fue de 0,8 segundos en transmisiones cerradas representativas de CI/CD.
Estos números describen el experimento. No le dicen cuántos incidentes reales se evitarían, cuántos paquetes legítimos se bloquearían en una organización o cuánto tiempo le tomaría a un equipo reconocer o descartar alertas.
La generalización sigue siendo la cuestión crítica
Los autores también reunieron un conjunto externo de 240 incidentes de cadena de software reales sin CVE, seleccionados manualmente. Este paso es relevante porque los CVE conocidos y las muestras sintéticas pueden enseñarle al modelo a reconocer el historial, no el siguiente ataque. Aún así, el conjunto externo es pequeño, específico y se describe como una evaluación preliminar.
En seguridad, la generalización debe sobrevivir a los cambios en el ecosistema, el lenguaje, el mantenedor, el patrón de publicación y el comportamiento adversario. Un F1 alto en un corte controlado no es una certificación para el flujo de lanzamiento de otra empresa.
La explicabilidad ayuda y también puede inducir a error
Una explicación podría hacer que la alerta sea auditable: cambio inusual de mantenedor, crecimiento abrupto de la dependencia, divergencia de metadatos o patrón extraño en el contenido. Esto ayuda al analista a formular la siguiente pregunta y registrar por qué decidió bloquear o liberar.
Pero los métodos de explicación suelen describir la contribución de las características a la salida del modelo. No prueban causalidad, intención maliciosa ni completitud. Una narrativa coherente aún puede estar equivocada. La explicación debe apuntar a evidencia externa verificable — paquete, firma, diff, provenance, ejecución aislada y contexto del repositorio — y no cerrar la investigación.
Qué mide la encuesta de desarrolladores
El estudio consultó a 82 desarrolladores. La claridad recibió una media de 4,3 sobre 5 y la procesabilidad, un 4,1. El noventa y seis por ciento declaró su intención de remediar basándose en las explicaciones. Estas son percepciones e intenciones autoinformadas. El experimento no mide la reducción real en el tiempo de aplicación de parches, la tasa de finalización, la calidad de los parches ni la reducción de incidentes después de la implementación.
La distinción protege la decisión: la satisfacción con la explicación es un signo de usabilidad, no una evidencia operativa de seguridad.
Un contrato seguro para el detector
- Sensor, no autoridad: el modelo recomienda prioridad; la política y los responsables definen bloqueo, excepción y release.
- Provenance: cada alerta registra paquete, versión, fuente, digest, momento, features, modelo y configuración.
- Evidencia externa: las explicaciones apuntan a artefactos que otra persona o herramienta puede verificar.
- Estado no concluyente: el sistema distingue benignos, sospechosos, confirmados y no verificables.
- Línea de base por ecosistema: npm y PyPI tienen patrones distintos; los umbrales y el coste del error deben medirse localmente.
- Defensa en profundidad: la firma, el archivo de bloqueo, el SBOM, la revisión de actualizaciones, el sandbox, el SCA, el análisis de comportamiento y la respuesta a incidentes siguen siendo necesarios.
- Deriva y revalidación: Se realiza un seguimiento del rendimiento y las explicaciones después de los cambios en el modelo, los datos y el ecosistema.
- Recibo de decisión: alerta, investigación, evidencia, excepción y autoridad quedan vinculados al release exacto.
Lo que no debería convertirse en una promesa.
El documento compara XAI-SCS con herramientas y enfoques existentes, pero no establece un reemplazo universal de SCA impulsado por Snyk, Dependabot o CVE. El aporte radica en la combinación de signos y explicaciones dentro del escenario estudiado. Las herramientas tradicionales continúan proporcionando inventario, políticas, integración e inteligencia operativa que un modelo experimental aislado no puede replicar.
Propuestas como el aprendizaje federado, las pruebas de conocimiento cero y los enclaves poscuánticos aparecen como direcciones futuras. No han sido validados mediante experimentos y no deben presentarse como capacidades actuales.
Los autores declaran no tener conflictos de interés. El trabajo recibió financiación de la National Cybersecurity Authority de Arabia Saudita, grant CRPG-25-3096. La declaración del artículo informa del uso de Grammarly, ChatGPT, Grok y Gemini para pulir el lenguaje, no para producir los resultados científicos. Hasta el corte del 04/10/2026 no localizamos una reproducción independiente del estudio completo.
regla de arquitectura
Un detector de cadena de software ofrece una hipótesis priorizada. Una explicación hace que esta hipótesis sea más inspeccionable. La seguridad sólo aparece cuando la organización conecta la señal con evidencia verificable, autoridad limitada, decisión registrada y monitoreo de resultados. [HARNESS31-C2]
El output útil no es ‘paquete seguro’. Es un paquete de evidencia: qué se observó, con qué versión del detector, qué explicación se produjo, qué verificación independiente ocurrió, qué quedó fuera del alcance y quién autorizó el release.
fuente directa
- Inteligencia artificial explicable para la seguridad de la cadena de suministro de software: Scientific Reports. Artículo, método, conjunto de datos, métricas, encuesta a desarrolladores, financiación y limitaciones.
Nota editorial y de responsabilidad
Este texto combina hechos atribuidos a la fuente con el análisis y propuesta técnica del autor. Las opiniones personales y profesionales no son hechos probados; Los datos, denominadores, límites y conflictos se indican cuando están disponibles. El contenido es informativo y no sustituye a la valoración técnica, jurídica, financiera o de seguridad. Tech Human y Trustyu trabajan comercialmente en temas relacionados. La investigación, la estructura y la redacción contaron con la ayuda de la IA; La revisión de los hechos, la aprobación del autor y la publicación fueron confirmadas por Fernando Parreiras el 4/10/2026, sin revisión humana independiente adicional.
Corte de investigación: 04/10/2026. Estado editorial: Resumen de evidencia especial autorizado para el 7/10/2026 a las 9 a.m. BRT.
Nota editorial y de responsabilidad
- Corte de la investigación
- Última revisión
- Correcciones registradas
- No hay correcciones registradas.
El corte anterior corresponde a los claims canónicos. Las fuentes complementarias y sus fechas de consulta se identifican en el cuerpo del artículo.
Este artículo combina fuentes citadas, análisis y experiencia profesional del autor. Los datos verificables y las afirmaciones fácticas están vinculados a sus respectivas fuentes. Las interpretaciones, hipótesis, proyecciones, recomendaciones y opiniones representan el punto de vista profesional del autor en el momento de la publicación; no constituyen hechos probados, promesas de resultados ni asesoramiento jurídico, financiero o técnico aplicable a un caso concreto. Consulte las fuentes originales y a profesionales cualificados antes de tomar decisiones.
Claims y fuentes
HARNESS31-C2
Un harness duradero debe mantener el historial de sesiones, la política de orquestación y el aislamiento de ejecución como límites explícitos, mientras que los adaptadores y complementos evitan que la elección del modelo o canal se convierta en el límite de seguridad.
Límite: Las fuentes muestran dos implementaciones, no un estándar de interoperabilidad neutral. Los permisos reales deben aplicarse y probarse de forma independiente fuera de las opciones del modelo. Este es un input de diseño source-bound; no prueba la adopción del producto, la madurez operativa, la attestation independiente, la clasificación de búsqueda, la citación de IA o el resultado.
- Anthropic — Anthropic, términos de sitio propietario
- Software YC —Software YC, MIT
- Software YC —Software YC, MIT