
Lectura ejecutiva · ~60 segundos
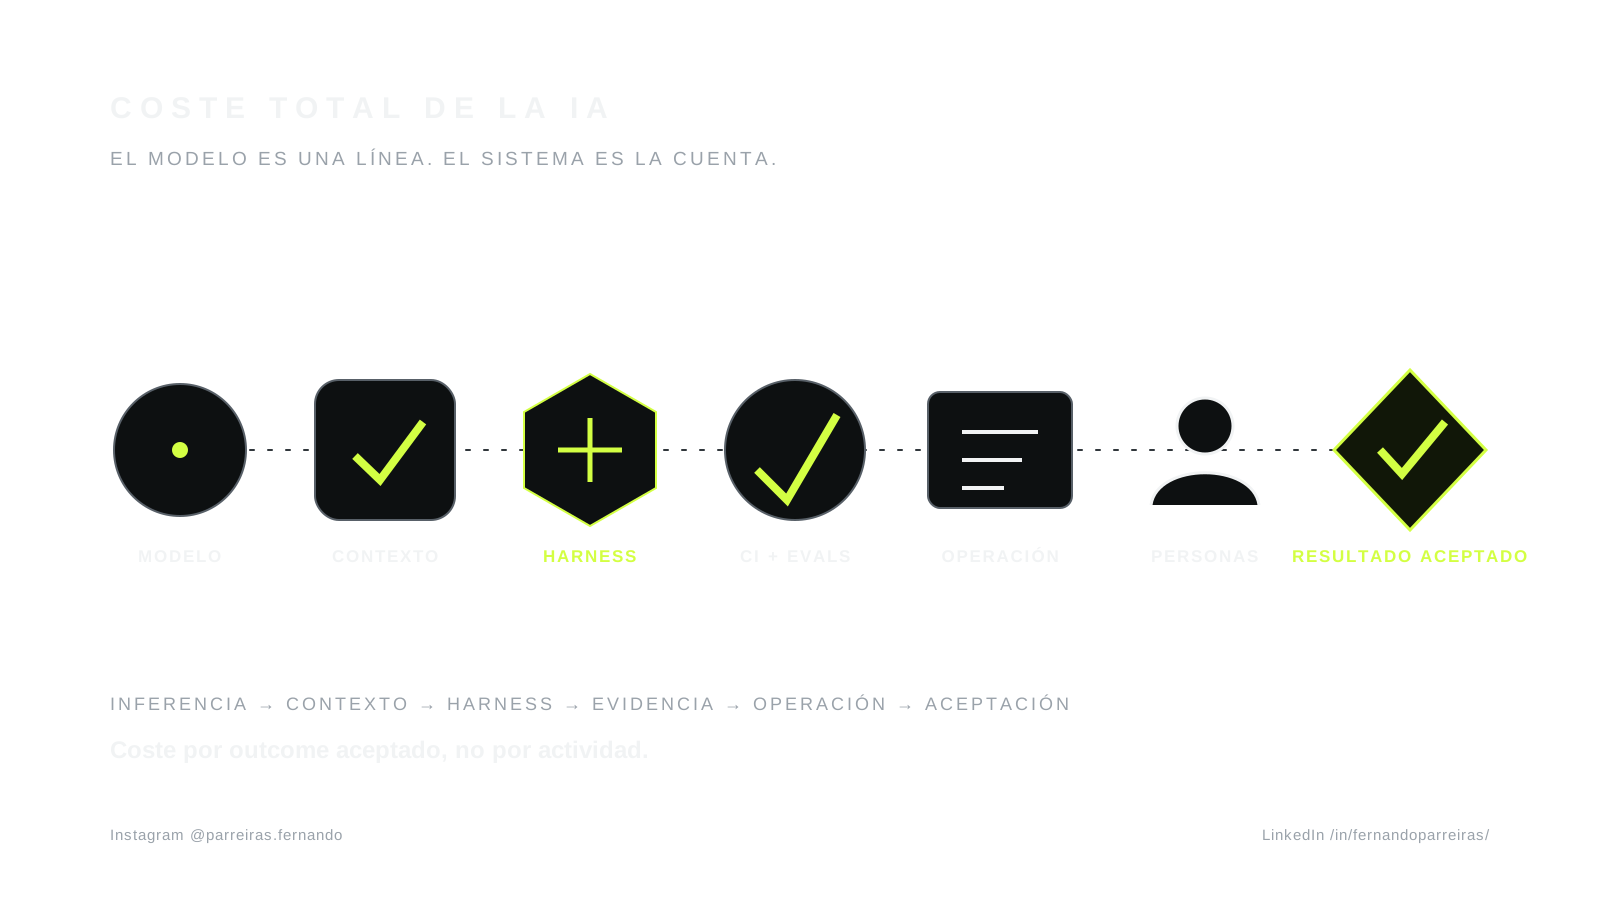
La inferencia se abarató de forma drástica, pero el coste migró al contexto, herramientas, harness, CI, evals, operación, trabajo humano y fallos. El denominador correcto es el outcome aceptado.
Entre noviembre de 2022 y octubre de 2024, el coste de inferencia de un sistema al nivel de GPT-3.5 cayó más de 280 veces, según el AI Index 2025 de Stanford. Estudios posteriores de Epoch AI también encuentran caídas rápidas cuando precio y rendimiento se comparan conjuntamente, aunque la tasa varía mucho según el benchmark. Esa transformación es real. Sin embargo, no demuestra que los productos de IA se hayan vuelto baratos.
El precio del modelo es solo la primera línea de una cadena que pasa por contexto, herramientas, orquestación, evals, CI, observabilidad, seguridad, intervención humana, incidentes y aprendizaje. A medida que la inferencia se abarata, crece la proporción relativa de esas otras cuentas. El cuello de botella cambia de lugar.
Resumen ejecutivo
El denominador útil no es una llamada, token o tarea iniciada. Es el resultado aceptado:
modelos + dados/contexto + ferramentas + execução/CI + verificação
+ operação + trabalho humano + falhas + evolução
---------------------------------------------------------------
outcomes aceitos
Esta fórmula no es una norma contable. Es un contrato de observabilidad para evitar que se celebre el ahorro de una capa mientras el coste, el riesgo o el retrabajo migran a otra.
La cadena completa
1. Inferencia: la partida visible
Tokens, imágenes, audio, caché, batch, reasoning y llamadas repetidas siguen siendo relevantes. Las caídas de precio no son uniformes entre calidad, modalidad, latencia o ventana de contexto. Compare modelos en la misma tarea, con el mismo criterio de aceptación y el mismo periodo; no convierta un benchmark en una factura futura.
2. Datos y contexto: lo que alimenta la decisión
Los documentos deben descubrirse, autorizarse, limpiarse, versionarse, indexarse y retirarse cuando caducan. Un retrieval barato con la fuente equivocada produce una respuesta barata y una decisión cara. Los costes de licencia, calidad, privacidad y gobernanza pertenecen a la misma unidad económica.
3. Herramientas e integraciones: cada acción amplía la superficie
Búsqueda, bases de datos, navegadores, colas, almacenamiento y APIs cobran dinero y complejidad. Un agente puede ejecutar muchas operaciones para completar una entrega. AWS Agentic AI Lens advierte que los ciclos de planificar, actuar, verificar y reflexionar, además de la coordinación multiagente, pueden aumentar consumo, latencia e invocaciones de herramientas. Un límite de coste sin condición de parada es solo una alerta tardía.
4. Harness y orquestación: hacer repetible la capacidad
Los prompts son una pieza. Estado, identidad, capabilities, enrutamiento, políticas, memoria, sandbox, timeouts, retries y handoffs forman el sistema. Anthropic recomienda comenzar con patrones simples y añadir comportamiento agéntico solo cuando mejora materialmente el resultado, porque la autonomía intercambia previsibilidad y latencia por rendimiento en tareas adecuadas.
El harness también acumula conocimiento experimental: qué modelo funciona para cada clase de tarea, qué contexto es suficiente, qué verificadores detectan fallos y cuándo escalar. Calibrarlo es una inversión; mantenerlo es un coste recurrente.
5. Evals y verificación: transformar producción en confianza
Los agentes son más difíciles de evaluar porque eligen rutas, usan herramientas y modifican el estado. La guía de evals de Anthropic recomienda conjuntos de tareas, graders y análisis de transcripciones; esas mediciones también crean líneas base de latencia, tokens, coste por tarea y tipos de error.
Eliminar evals hace que la cuenta parezca menor porque deja de medir el fallo. Demasiados evals mal elegidos crean una CI lenta y cara. El objetivo es una cobertura proporcional al riesgo, con muestreo, tiers y gates deterministas antes de jueces más caros.
6. CI e infraestructura: el impuesto del cambio frecuente
Cada cambio de prompt, modelo, herramienta, policy, dataset o dependencia puede exigir pruebas, builds, entornos efímeros, scanners, runners, almacenamiento y repetición. Los sistemas AI-native elevan la tasa de cambio y el número de configuraciones posibles. Sin selección de pruebas por riesgo, caché segura, concurrencia controlada y entornos con caducidad, el coste de demostrar un cambio puede superar el coste de ejecutarlo.
Esta es una señal de madurez, no un argumento para eliminar CI. La pregunta es: ¿qué evidencia debe producirse para esta clase de cambio y qué ejecución duplicada no añade confianza?
7. Operación y seguridad: el sistema después del despliegue
Gateway, observabilidad, egress, secrets, identidad, rate limits, aislamiento, retención, soporte y recuperación no aparecen en la demo. NIST AI RMF y su perfil para IA generativa tratan la medición, el monitoreo y la gestión de riesgos como trabajo continuo. No hay ahorro sostenible cuando se eliminan logs, controles o rollback para reducir la factura actual.
8. Trabajo humano: la cuenta que suele desaparecer
Las personas preparan casos, revisan excepciones, explican decisiones, recuperan fallos y atienden a clientes. State of FinOps 2026 informa que el 98% de los encuestados ya gestiona gasto en IA, pero solo el 28% incluye el trabajo en la cuenta. El estudio cubre 1.192 profesionales que representan más de US$83 mil millones en gasto anual de cloud; es un retrato de la comunidad FinOps, no de todas las empresas.
La revisión humana no es automáticamente desperdicio. Puede ser el control correcto. Debe aparecer por clase de tarea y consecuencia para que precio, margen y automatización sean decisiones honestas.
9. Fallo, retrabajo y deuda: costes que llegan después
Una salida rechazada consume todas las capas anteriores y no entra en el denominador. Los incidentes suman investigación, contención, comunicación, rollback y confianza. Hace más de una década, el paper *Hidden Technical Debt in Machine Learning Systems* mostró que las ganancias rápidas de ML pueden cargar costes de mantenimiento por dependencias de datos, feedback loops, configuración y erosión de fronteras. Los LLM cambiaron la interfaz; no eliminaron esa dinámica.
10. Energía y capacidad: la cuenta sistémica
La IEA estima que el consumo eléctrico global de los centros de datos pase de unos 485 TWh en 2025 a aproximadamente 950 TWh en 2030, con una gran participación de la IA. Este escenario no debe atribuirse linealmente a una llamada o producto. Muestra que energía, red, chips, ubicación y plazos de capacidad pueden reaparecer como precio, límite y riesgo de cadena de suministro.
Cuatro decisiones de ingeniería que cambian la curva
Enrute por tarea, no por prestigio
FrugalGPT y RouteLLM muestran, en benchmarks y configuraciones específicas, que las cascadas y el enrutamiento pueden reducir costes preservando la calidad. Los resultados no son una garantía de producción. El patrón transferible es mantener un conjunto de casos, un criterio de aceptación y un fallback, y promover la ruta más barata que supera el gate.
Incluya condiciones de parada en el presupuesto
Los límites de turnos, tiempo, tokens, llamadas, mutación y coste deben producir stop, escalate o inconclusive; nunca un pass por agotamiento. El presupuesto es una propiedad del contrato de ejecución, no un panel observado después.
Mida goodput, no actividad
Throughput cuenta intentos. Goodput cuenta resultados válidos dentro de los objetivos de calidad y latencia. FinOps Foundation propone conectar tokens, inferencia y workflow con el coste por outcome. En FORGE, el equivalente es preservar un receipt que vincule versión, coste, verificador y aceptación. La observabilidad debe llegar a una unidad de valor y su coste, no detenerse en el recurso técnico. [R3-C2]
Trate CI como un portafolio de evidencias
Organice las suites por capas: contratos deterministas y rápidos; integración selectiva; evals por muestreo; red team y ensayos prolongados con su propia cadencia. Registre tasa de fallo, flakiness, tiempo, coste y bugs detectados por suite. Desactivar una prueba requiere evidencia de redundancia o irrelevancia, no solo una factura alta.
El panel mínimo por outcome
| Dimensión | Pregunta | Señal mínima |
|---|---|---|
| Valor | ¿el resultado fue aceptado y utilizado? | outcomes aceptados / iniciados |
| Calidad | ¿qué falló y dónde se detectó? | error por clase y gate |
| Modelo | ¿cuánto se consumió para las salidas aceptadas? | coste de inferencia / outcome |
| Plataforma | ¿qué recursos sostuvieron el flujo? | compute, almacenamiento, red y herramientas |
| evidencia | ¿cuánto costó demostrar el cambio? | CI + evals + revisión por release |
| Personas | ¿dónde fue necesaria la intervención? | minutos y motivo por clase |
| fracaso | ¿qué coste escapó del flujo normal? | retrabajo, incidentes y recuperación |
No use cero cuando el dato no existe. Use unknown, declare el método de asignación y concilie la estimación con las interfaces oficiales de facturación. Una estimación de tokens no sustituye una factura. [R3-C3]
Lo que puede venir después
Cinco presiones tienden a ganar importancia:
- Coste de las pruebas. Una mayor autonomía exigirá más evidencia de autorización, procedencia y verificación; la prueba podrá convertirse en una clase explícita de infraestructura.
- Volatilidad de margen. El precio por outcome transfiere al proveedor el riesgo de retries, excepciones y cambios de modelo; el gross margin deberá observarse por cohorte y tarea.
- Escasez localizada. La energía, los chips, la red, la residencia de datos y las ventanas de capacidad pueden limitar la expansión incluso cuando cae el precio nominal del modelo.
- Deuda de evaluación. Las suites envejecen, los datasets dejan de representar el uso y los graders pueden compartir los sesgos del generador. Mantener la medición será un producto interno continuo.
- Portabilidad económica. Cambiar de modelo será simple en el diagrama y caro en el comportamiento: prompts, herramientas, latencia, seguridad y tasa de aceptación deberán recalibrarse.
Estas son hipótesis de planificación, no previsiones confirmadas. El propósito es hacerlas observables antes de que se conviertan en una sorpresa financiera.
Un plan de 30 días
- elija un flujo con volumen, responsable y criterio de aceptación;
- registre una línea base de coste, latencia, retrabajo e intervención;
- asigne tags de versión, modelo, tarea, cliente/cohorte y entorno;
- sume modelo, plataforma, herramientas, CI/evals y tiempo humano;
- divida por outcomes aceptados, preservando
unknown; - encuentre las dos mayores partidas y las dos mayores causas de rechazo;
- ejecute un cambio por vez y compare con el mismo conjunto de casos;
- mantenga calidad, riesgo y margen como guardrails simultáneos.
Limitaciones y conflictos de interés
- Stanford, Epoch AI, METR, FrugalGPT y RouteLLM estudian periodos, tareas y benchmarks diferentes; ninguna cifra debe proyectarse directamente sobre una empresa.
- El estudio de METR encontró una desaceleración del 19% en 246 tareas realizadas por 16 desarrolladores experimentados en repositorios open source maduros. Es evidencia importante contra las generalizaciones, no una estimación universal de productividad.
- AWS, Anthropic y Stripe son proveedores con intereses comerciales en las categorías que describen.
- Bessemer es inversora; sus referencias de margen son una tesis de mercado, no una auditoría independiente.
- La IEA describe infraestructura global; no atribuye consumo a este artículo, a FORGE ni a ningún producto.
- Trustyu y Tech Human prestan comercialmente servicios de arquitectura, gobernanza y construcción de productos de IA.
Fuentes directas
- Stanford HAI — AI Index Report 2025.
- Epoch AI — LLM inference price trends.
- FinOps Foundation — State of FinOps 2026.
- FinOps Foundation — FinOps for AI.
- AWS — Agentic AI Lens: Cost Optimization.
- Anthropic — Building effective agents.
- Anthropic — Demystifying evals for AI agents.
- Sculley et al. — Hidden Technical Debt in Machine Learning Systems.
- NIST — Generative AI Profile, NIST AI 600-1.
- IEA — Key questions on energy and AI.
- Chen et al. — FrugalGPT.
- Ong et al. — RouteLLM.
- METR — Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity.
- DORA — Estado del desarrollo de software asistido por IA 2025.
Nota editorial y de responsabilidad
Los datos y las conclusiones se vincularon a las fuentes indicadas y se leyeron dentro de su alcance. La cadena de costes, el panel y el plan de 30 días son una síntesis profesional del autor, no una norma contable, una promesa de ahorro ni una afirmación sobre costes privados de Trustyu. El contenido es informativo y no sustituye una evaluación financiera, técnica, jurídica o de seguridad. La investigación y la redacción contaron con asistencia de IA; la revisión factual, la autoría y la aprobación de publicación pertenecen a Fernando Parreiras. No hubo revisión humana independiente adicional.
Nota editorial y de responsabilidad
- Corte de la investigación
- Última revisión
- Correcciones registradas
- No hay correcciones registradas.
El corte anterior corresponde a los claims canónicos. Las fuentes complementarias y sus fechas de consulta se identifican en el cuerpo del artículo.
Este artículo combina fuentes citadas, análisis y experiencia profesional del autor. Los datos verificables y las afirmaciones fácticas están vinculados a sus respectivas fuentes. Las interpretaciones, hipótesis, proyecciones, recomendaciones y opiniones representan el punto de vista profesional del autor en el momento de la publicación; no constituyen hechos probados, promesas de resultados ni asesoramiento jurídico, financiero o técnico aplicable a un caso concreto. Consulte las fuentes originales y a profesionales cualificados antes de tomar decisiones.
Claims y fuentes
R3-C2
Una observabilidad útil de la IA debe conectar la telemetría técnica con una unidad de valor y su costo, en lugar de optimizar el gasto agregado sin un denominador de resultado.
Límite: Una unidad debe ser específica de un producto; Esta ejecución basada únicamente en el marco mide el costo de intake, pero no el resultado del cliente. Este es un insumo de diseño de investigación-síntesis; no prueba la adopción del producto, la madurez operativa, la attestation independiente o el resultado.
- OpenTelemetry — OpenTelemetry, documentación CC-BY-4.0; extractos de solo análisis
- FinOps Fundación — Fundación FinOps, marco CC-BY-4.0; extractos de solo análisis
R3-C3
La conciliación financiera debe utilizar el uso oficial del proveedor o las interfaces de costos y mantener lo desconocido como desconocido; Las estimaciones simbólicas no sustituyen a las facturas.
Límite: No se utilizó ninguna credencial de administrador de proveedor ni llamada de modelo distinta de cero en esta ejecución de solo marco, por lo que el gasto del modelo en vivo permanece no configurado en lugar de cero. Este es un insumo de diseño de investigación-síntesis; no prueba la adopción del producto, la madurez operativa, la attestation independiente o el resultado.
- OpenAI — OpenAI, documentación del SDK de Apache-2.0; extractos de solo análisis
- Anthropic — Anthropic, repositorio del MIT; extractos de solo análisis
- Nube de Google — Google Cloud, modelo oficial de Google Cloud de Apache-2.0; extractos de solo análisis
- GitHub — Documentación GitHub, CC-BY-4.0; extractos de solo análisis