
Lectura ejecutiva · ~60 segundos
En 112 bugs de 84 proyectos, el PoC-pass alcanzó 90,2% con el modelo más nuevo, pero las pruebas de desarrolladores quedaron en 60,7%; 32,7% de los casos aprobados por el PoC aún fallaron en el oráculo de intención. Un benchmark de patch debe declarar información, aislamiento, oráculos y errores del pipeline.
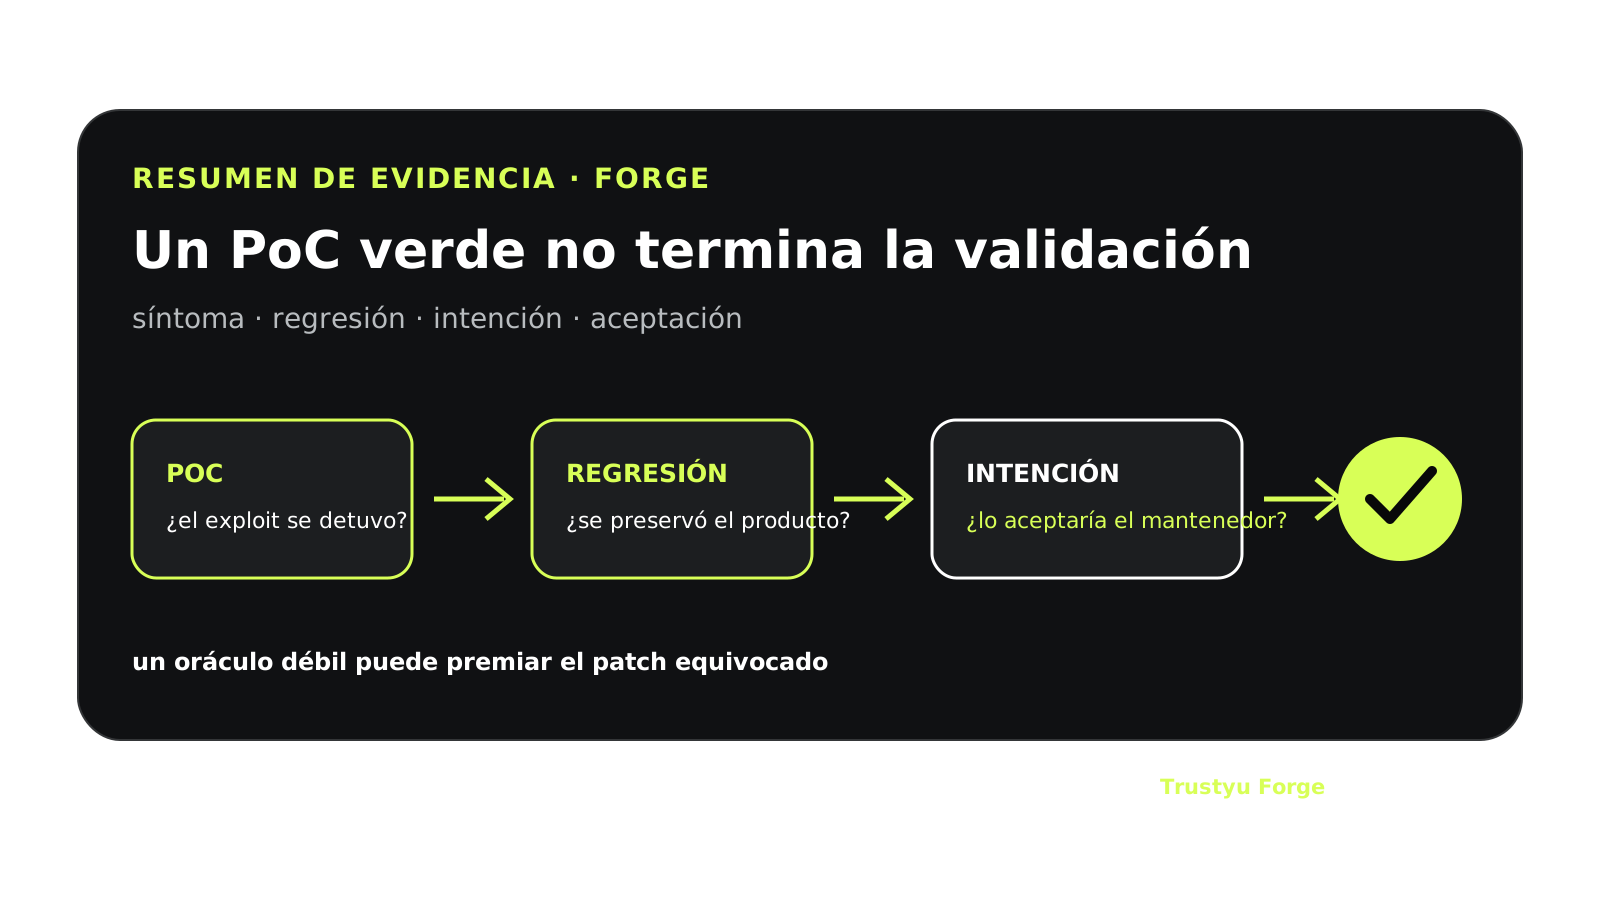
Una reparación puede impedir el exploit conocido, preservar la suite de regresión y aun así contrariar el diseño que aceptaría el mantenedor. Cuando el benchmark solo mide si el Proof of Concept dejó de funcionar, la supresión del síntoma puede recibir el mismo crédito que la corrección de la causa.
Estado: Evidence Brief aprobado para publicación. Serie editorial: Papers que leemos por ti. Este texto analiza el preprint *On the Reliability of LLM-Based Vulnerability Patching Benchmarks*. No afirma que Trustyu Forge haya reproducido los experimentos, que las pruebas de desarrolladores sean un oráculo perfecto ni que los porcentajes se transfieran a otra herramienta, modelo o base de código.
El conjunto evaluado
Los investigadores curaron 112 bugs históricos de seguridad en 84 proyectos open source escritos en C/C++, Go y Rust. Cada caso incluye tres capas de evaluación: un PoC asociado al problema, las pruebas de regresión existentes y pruebas adicionales derivadas de cambios aceptados por los desarrolladores. La última capa busca capturar decisiones de API, ubicación de la corrección e intención de diseño que detener el crash puede no preservar.
El estudio ejecutó tres experimentos controlados y cinco estudios de caso. También examinó 13 benchmarks y conjuntos de vulnerabilidades existentes para identificar factores de agente, framework y dataset que cambian el puntaje sin mejorar necesariamente el patch.
La diferencia entre pasar el PoC y satisfacer al mantenedor
Con el mismo harness OpenCode y 112 casos, los autores compararon Claude Sonnet 4.0, Sonnet 4.5 y Opus 4.7. La tasa de PoC-pass reportada subió de 77,7% a 84,8% y 90,2%. La aprobación en pruebas de desarrolladores subió de 43,8% a 48,2% y 60,7%. Las regresiones quedaron en 97,3%, 94,6% y 94,6%.
Incluso en la mejor condición, 32,7% de los casos que pasaron el PoC fallaron en las pruebas de desarrolladores. Para Sonnet 4.0 y 4.5, esa proporción fue 43,7% y 43,2%. El resultado no significa que un tercio de todo patch generado por IA esté equivocado. Significa que, en ese conjunto y harness, un oráculo basado solo en el PoC contó como éxito cambios que otro conjunto de requisitos rechazó.
El harness también cambia el puntaje
En el experimento con Sonnet 4.0, proporcionar instrucciones detalladas de build y pruebas elevó el PoC-pass general de 74,1% a 77,7%, mientras que la aprobación en pruebas de desarrolladores pasó de 41,1% a 43,8%. En C/C++, el efecto en el PoC fue mucho mayor: 72% sin instrucciones y 92% con instrucciones. La aprobación en pruebas de desarrolladores cambió de 28% a 36%.
Esto no hace malas a las instrucciones; un agente necesita saber cómo operar el proyecto. El punto es metodológico: los puntajes no son comparables sin declarar qué información, herramientas, red, historial Git y feedback puso el harness a disposición. El benchmark mide la combinación modelo–agente–harness–dataset–oráculo, no una capacidad aislada del modelo.
Un contrato mínimo de evaluación de patches
- PoC: prueba que la ruta conocida dejó de producir el efecto explotable.
- Regresión: protege el comportamiento ya cubierto antes de la corrección.
- Intención del mantenedor: añade pruebas para semántica, API, ubicación y estrategia esperadas.
- Variaciones adversariales: cambia entradas y rutas para distinguir una corrección general del bloqueo de un caso único.
- Aislamiento: elimina historial, patch de referencia, red y artefactos que revelen la respuesta, salvo cuando esos recursos forman parte de la pregunta evaluada.
- Errores del pipeline: separa timeout, permisos, colisión de pruebas y fallo de infraestructura de un fallo real del patch.
- Revisión humana: preserva un juicio proporcional al riesgo antes de promoción o release.
regla de arquitectura
El receipt de una reparación no puede ser solo “PoC verde”. Debe registrar el bug, la hipótesis de causa, el patch, la información ofrecida al agente, los oráculos ejecutados, los efectos secundarios, el resultado de las pruebas añadidas por el mantenedor y quién aceptó el cambio. Sin esa cadena, el puntaje mide una configuración de laboratorio y no prueba preparación para release. [R2-C3]
En Forge, el conjunto de pruebas es un contrato de evidencia con capas y provenance. Generar el patch y generar o seleccionar el oráculo son responsabilidades que deben seguir siendo distinguibles; cuando la misma trayectoria controla ambos sin revisión, puede optimizar para la prueba en vez de corregir el producto.
Límites y conflicto de interés
El paper está en la versión v1 del 07/10/2026. El conjunto se curó a partir de bugs históricos públicos, por lo que puede sufrir contaminación o memorización. Las pruebas adicionales derivadas del upstream son un proxy de intención, no una especificación completa ni una prueba formal de corrección. Los resultados dependen del harness, prompts, herramientas, versiones de modelos y políticas de timeout adoptadas.
Hasta el corte editorial no localizamos una replicación independiente completa ni un artefacto público único con todo el conjunto anunciado. Los autores declaran afiliaciones con Northwestern University; no localizamos conflicto comercial declarado con los proveedores de modelos citados. La ausencia de un conflicto identificado no prueba independencia absoluta.
Fuentes directas
- On the Reliability of LLM-Based Vulnerability Patching Benchmarks — arXiv. Preprint, autores, resumen, versión y fecha.
- On the Reliability of LLM-Based Vulnerability Patching Benchmarks — texto completo. Método, denominadores, resultados, estudios de caso, survey y limitaciones.
Nota editorial y de responsabilidad
Este texto combina hechos atribuidos a las fuentes con análisis y propuesta técnica del autor. Los puntos de vista personales y profesionales no son hechos comprobados; datos, denominadores, limitaciones, afiliaciones y ausencia de replicación independiente se indican cuando están disponibles. El contenido es informativo y no sustituye una evaluación técnica, jurídica, financiera o de seguridad. Los nombres de productos pertenecen a sus titulares; no existe patrocinio ni respaldo. Tech Human y Trustyu actúan comercialmente en desarrollo y gobernanza de productos digitales. La investigación, estructura y redacción tuvieron asistencia de IA; la revisión factual, aprobación autoral y publicación fueron autorizadas por Fernando Parreiras el 08/10/2026, sin revisión humana independiente adicional.
Corte de investigación: 08/10/2026. Estado editorial: Evidence Brief especial autorizado para el 15/10/2026 a las 09:00 BRT.
Nota editorial y de responsabilidad
- Corte de la investigación
- Última revisión
- Correcciones registradas
- No hay correcciones registradas.
El corte anterior corresponde a los claims canónicos. Las fuentes complementarias y sus fechas de consulta se identifican en el cuerpo del artículo.
Este artículo combina fuentes citadas, análisis y experiencia profesional del autor. Los datos verificables y las afirmaciones fácticas están vinculados a sus respectivas fuentes. Las interpretaciones, hipótesis, proyecciones, recomendaciones y opiniones representan el punto de vista profesional del autor en el momento de la publicación; no constituyen hechos probados, promesas de resultados ni asesoramiento jurídico, financiero o técnico aplicable a un caso concreto. Consulte las fuentes originales y a profesionales cualificados antes de tomar decisiones.
Claims y fuentes
R2-C3
Los privilegios mínimos, la ejecución aislada y la provenance de la cadena de suministro son controles complementarios; no hay sustitutos para los demás en un sistema agente.
Límite: El perfil de control exacto sigue siendo específico del entorno y debe modelarse en función de las amenazas para cada producto. Este es un insumo de diseño de investigación-síntesis; no prueba la adopción del producto, la madurez operativa, la attestation independiente o el resultado.
- OpenAI — OpenAI, repositorio Apache-2.0; extractos de solo análisis
- OWASP Fundación — OWASP Fundación, estándar CC-BY-SA-4.0; extractos de solo análisis
- OpenSSF SLSA — OpenSSF SLSA, CC-BY-4.0 especificación; extractos de solo análisis