Lectura ejecutiva · ~60 segundos
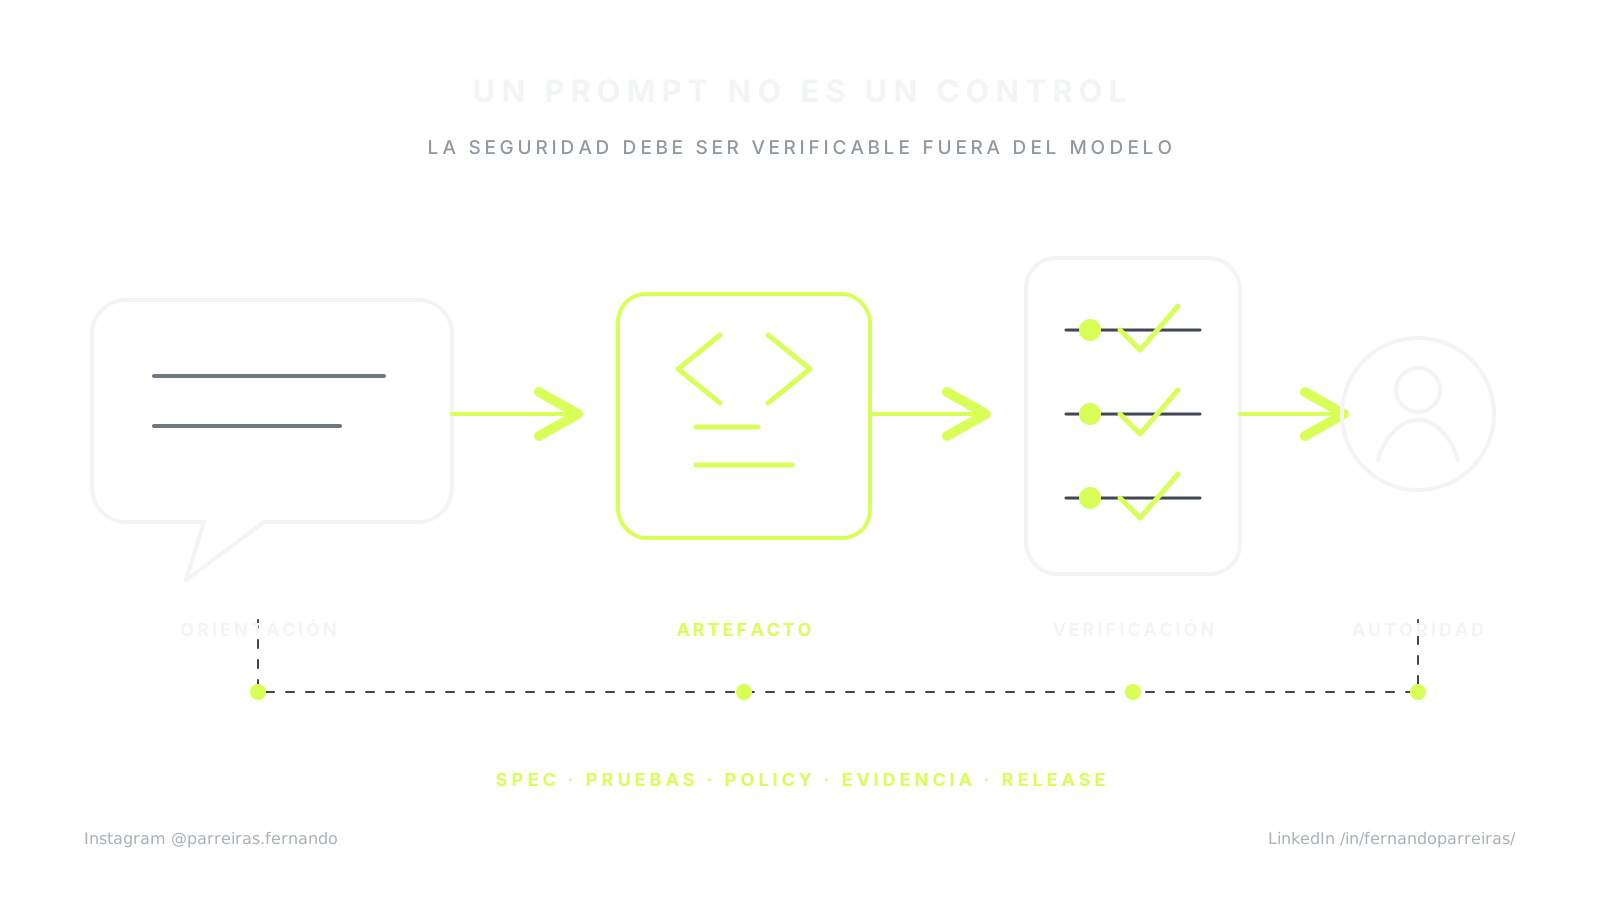
Los prompts de seguridad orientan al generador, pero no demuestran propiedades en el software. El control requiere spec, mecanismos externos, pruebas, autoridad y evidencia vinculada al artefacto exacto.
Escribir “use buenas prácticas” o “genere código seguro” en el prompt puede orientar al modelo. Por sí solo, no crea una propiedad verificable en el sistema entregado. El mismo generador que recibió la instrucción no puede ser la única autoridad que declare que la cumplió.
Este Evidence Brief parte del paper Prompt Structure Redistributes, Not Reduces para separar cuatro capas que suelen mezclarse: orientación de generación, comportamiento producido, finding de herramienta y riesgo aceptado. El estudio respalda la necesidad de esta separación; el contrato técnico que sigue es una propuesta profesional de Trustyu Forge, no una conclusión experimental de los autores.
Qué se midió
Los investigadores utilizaron 424 tareas Python de un dataset sintético orientado a vulnerabilidades. Cada tarea pasó una vez por cinco variantes de prompt y dos modelos — GPT-4o y LLaMA 3.1-8B — en un diseño zero-shot. Son 4.240 interacciones. Los outputs con Python válido fueron analizados con Bandit y CodeQL.
La primera variable fue el compliance de generación, no la seguridad. Con GPT-4o, los outputs no válidos bajaron de 338 en 424 tareas con el prompt mínimo a 37–52 con los prompts estructurados. Con LLaMA, la respuesta fue menos estable. Por lo tanto, un prompt estructurado cambió considerablemente la probabilidad de tener código para analizar — y cambió el denominador de las comparaciones siguientes.
Condicionadas al código válido, las orientaciones de seguridad no redujeron de forma consistente la prevalencia total de debilidades detectadas. Con GPT-4o, los findings de alta severidad pasaron del 20,8% al 13,6%, mientras que los de baja severidad aumentaron del 32% al 43,5%. Los efectos de LLaMA fueron menos consistentes. El resultado observado fue una redistribución dependiente del modelo, no una eliminación uniforme.
Lo que estos números no demuestran
- el corpus no representa aplicaciones reales en producción;
- Python, dos modelos y una generación por configuración no admiten una generalización universal;
- los findings de Bandit y CodeQL son señales estáticas, no confirmación de explotabilidad;
- las herramientas estáticas pueden producir falsos positivos y falsos negativos;
- el estudio no ejecutó un amplio programa de pruebas funcionales y dinámicas;
- la auditoría manual de relevancia y deriva cubrió 15 de las 424 tareas;
- el paquete de replicación está disponible, pero no había replicación independiente en la fecha de corte de este brief.
El propio paper informa comportamientos relevantes en outputs que ninguna de las dos herramientas señaló y declara que el runtime, el contexto y la lógica requieren análisis complementarios. Un resultado verde reduce una clase de incertidumbre; no concluye el análisis de seguridad.
Compliance, corrección y seguridad son gates diferentes
| Gate | Pregunta | Evidencia mínima |
|---|---|---|
| generación | ¿el modelo produjo un artefacto analizable? | output preservado + parser/build |
| corrección | ¿el software cumple la spec autorizada? | pruebas funcionales, contratos y casos límite |
| seguridad | ¿resiste las amenazas y abusos relevantes? | threat model, pruebas negativas y SAST/SCA/DAST según el riesgo |
| aceptación | ¿se puede promover el riesgo residual? | findings resueltos, excepciones aprobadas y autoridad identificada |
| operación | ¿sigue siendo confiable en el entorno real? | telemetría, SLOs, incidentes, rollback y revalidación |
Un prompt puede influir en el primer gate y ayudar en los siguientes. No debe tener autoridad para omitirlos. [HARNESS31-C2]
La deriva semántica también necesita pruebas
En la muestra manual del paper, los prompts de seguridad más fuertes llevaron a GPT-4o a sustituir o eliminar construcciones inseguras solicitadas explícitamente. La deriva semántica pasó de 3/15 en el baseline estructurado a 9–10/15 en las variantes posteriores. Como el benchmark contiene solicitudes deliberadamente peligrosas, cambiar la implementación puede ser deseable. Aun así, reducir findings al cambiar el comportamiento no demuestra que la implementación haya preservado la decisión de producto.
Por eso, la seguridad y la fidelidad a la spec no deben competir dentro del texto del prompt. La spec declara el comportamiento autorizado y sus invariantes. El threat model declara abuso, activos y límites. Las pruebas demuestran ambas cosas mediante mecanismos separados.
Contrato técnico: la orientación no puede convertirse en autoridad
1. Especificación antes de la generación
Registre funcionalidad, datos, identidades, capacidades, dependencias, límites, casos prohibidos y criterios de aceptación. El texto ambiguo del prompt debe seguir siendo un riesgo explícito, no un requisito implícitamente “entendido” por el modelo.
2. Controles fuera del modelo
La autorización, el aislamiento, los secretos, las políticas de red, los límites de recursos, la protección de datos y los release gates deben existir como mecanismos de plataforma. El modelo puede sugerir una configuración; no debe reescribir silenciosamente la política que evalúa su propio output.
Un workspace separado ayuda a reducir las colisiones, pero no equivale a una sandbox con egress, identidad, capabilities y recursos controlados. [R1-C2]
3. Verificación multimétodo
Combine mecanismos según el riesgo:
- lint, tipos y build para integridad básica;
- pruebas unitarias, de contrato y de regresión para comportamiento;
- SAST y análisis semántico para patrones y flujos conocidos;
- SCA, SBOM y policy para dependencias y provenance;
- pruebas negativas, fuzzing o DAST cuando la superficie lo justifique;
- revisión especializada para identidad, autorización, criptografía, datos e infraestructura;
- evals cuando el comportamiento del modelo permanezca dentro del producto.
Ninguna herramienta individual es un certificado. Las divergencias, suppressions y áreas no cubiertas entran en el registro de riesgos.
4. Autoridad y segregación
Quien genera puede activar pruebas y proponer correcciones. Quien verifica necesita criterios protegidos. Quien acepta el riesgo debe estar identificado y autorizado. Los roles distintos solo crean un contrapunto cuando preservan permisos, inputs, findings y decisiones; nombres diferentes en el prompt no demuestran independencia. [R1-C3]
5. Release vinculado al artefacto exacto
Los checks deben apuntar al commit evaluado. El build debe generar un artefacto identificado por digest. La aprobación debe hacer referencia a ese mismo objetivo y la promoción debe producir un receipt. Si un nuevo push cambia el código, la evidencia anterior deja de autorizar el release.
Evidence Packet mínimo
Para cada cambio asistido por IA con impacto material, preserve:
- spec, threat model y la decisión que inició el trabajo;
- proveedor/modelo cuando esté disponible, configuración y hash del prompt reutilizable;
- commit base, diff e identidad del ejecutor;
- versiones y configuraciones de los verificadores;
- pruebas ejecutadas, resultados y artefactos brutos relevantes;
- findings confirmados, descartados, mitigados o aceptados, con justificación;
- suppressions y excepciones con owner y período de validez;
- aprobación humana vinculada al commit y al digest del artefacto;
- receipt de promoción, smoke test, observabilidad y rollback;
- limitaciones conocidas y próxima revalidación.
Si la organización solo puede mostrar el prompt “seguro”, tiene una intención. Si muestra controles, resultados, autoridad y artefacto, tiene evidencia.
Gate proporcional al riesgo
| Superficie | Gate esperado antes del merge |
|---|---|
| copy o UI reversible | build, pruebas del componente y accesibilidad |
| regla de negocio | contrato, regresión, casos límite y owner del dominio |
| identidad y autorización | threat model, pruebas negativas y revisión especializada |
| datos y migración | integridad, dry run, backup, rollback y aprobación responsable |
| infraestructura y release | policy, least privilege, provenance, smoke test y autoridad de producción |
La tabla es orientación profesional, no un resultado del paper. El perfil exacto depende del impacto, la exposición, la reversibilidad y las obligaciones del producto.
Lo que demuestra este brief, y lo que no prueba
El estudio aporta evidencia de que la estructura del prompt puede cambiar el compliance, la severidad y la composición de los findings en un benchmark controlado. No demuestra que los prompts sean inútiles, que un modelo sea universalmente inseguro o que los findings encontrados sean explotables en producción.
El brief propone que los prompts de seguridad permanezcan en el flujo como orientación de defensa en profundidad. Sin embargo, la afirmación de seguridad debe apoyarse en propiedades especificadas, verificadores protegidos, autoridad explícita y evidencia vinculada al software exacto.
Fuentes directas
- Paper en arXiv
- Versión HTML completa
- Paquete de replicación en Zenodo
- Dataset de origen
- Bandit
- CodeQL
- NIST SP 800-218 — Secure Software Development Framework
Conclusión
“Hazlo seguro” es una instrucción útil. “Fue verificado, aprobado y promovido bajo estos controles” es una afirmación gobernable.
En la ingeniería AI-native, el prompt inicia el trabajo. La arquitectura, las pruebas, la autoridad y el Evidence Packet determinan si el resultado puede operar.
Nota editorial y de responsabilidad
- Corte de la investigación
- Última revisión
- Correcciones registradas
- No hay correcciones registradas.
El corte anterior corresponde a los claims canónicos. Las fuentes complementarias y sus fechas de consulta se identifican en el cuerpo del artículo.
Este artículo combina fuentes citadas, análisis y experiencia profesional del autor. Los datos verificables y las afirmaciones fácticas están vinculados a sus respectivas fuentes. Las interpretaciones, hipótesis, proyecciones, recomendaciones y opiniones representan el punto de vista profesional del autor en el momento de la publicación; no constituyen hechos probados, promesas de resultados ni asesoramiento jurídico, financiero o técnico aplicable a un caso concreto. Consulte las fuentes originales y a profesionales cualificados antes de tomar decisiones.
Claims y fuentes
HARNESS31-C2
Un harness duradero debe mantener el historial de sesiones, la política de orquestación y el aislamiento de ejecución como límites explícitos, mientras que los adaptadores y complementos evitan que la elección del modelo o canal se convierta en el límite de seguridad.
Límite: Las fuentes muestran dos implementaciones, no un estándar de interoperabilidad neutral. Los permisos reales deben aplicarse y probarse de forma independiente fuera de las opciones del modelo. Este es un input de diseño source-bound; no prueba la adopción del producto, la madurez operativa, la attestation independiente, la clasificación de búsqueda, la citación de IA o el resultado.
- Anthropic — Anthropic, términos de sitio propietario
- Software YC —Software YC, MIT
- Software YC —Software YC, MIT
R1-C2
Autonomy should be bounded by aislation and small reviewable changes; a worktree alone is not a security boundary and a large change weakens review quality.
Límite: Change-size guidance is human-review guidance; it does not by itself define an agent sandbox policy. This is a research-synthesis design input; it does not prove product adoption, operational maturity, independent attestation or outcome.
R1-C3
Los equipos de múltiples agentes y la arquitectura en evolución requieren roles de orquestación explícitos además de registros de decisiones duraderos con estado, consecuencias y sustitución.
Límite: Las fuentes no prescriben una topología de equipo universal o una plantilla ADR. Este es un insumo de diseño de investigación-síntesis; no prueba la adopción del producto, la madurez operativa, la attestation independiente o el resultado.
- Microsoft — Microsoft, repositorio MIT/CC-BY-4.0; extractos de solo análisis
- Servicios web de Amazon — Amazon Web Services, orientación oficial pública; extractos de solo análisis
- MicrosoftAzure — Microsoft Azure, orientación oficial pública; extractos de solo análisis