
Leitura executiva · ~60 segundos
O HarnessSecurity-Bench encontrou, em uma avaliação controlada, aumento de utilidade de 77,1% para 95,4% ao ativar auto-approve, acompanhado por crescimento da taxa de efeitos adversariais de 29,2% para 95,6%. O resultado não é uma taxa de incidentes reais: é evidência de que remover confirmação altera a autoridade efetiva do agente e precisa de escopo, testes de negação e receipts.
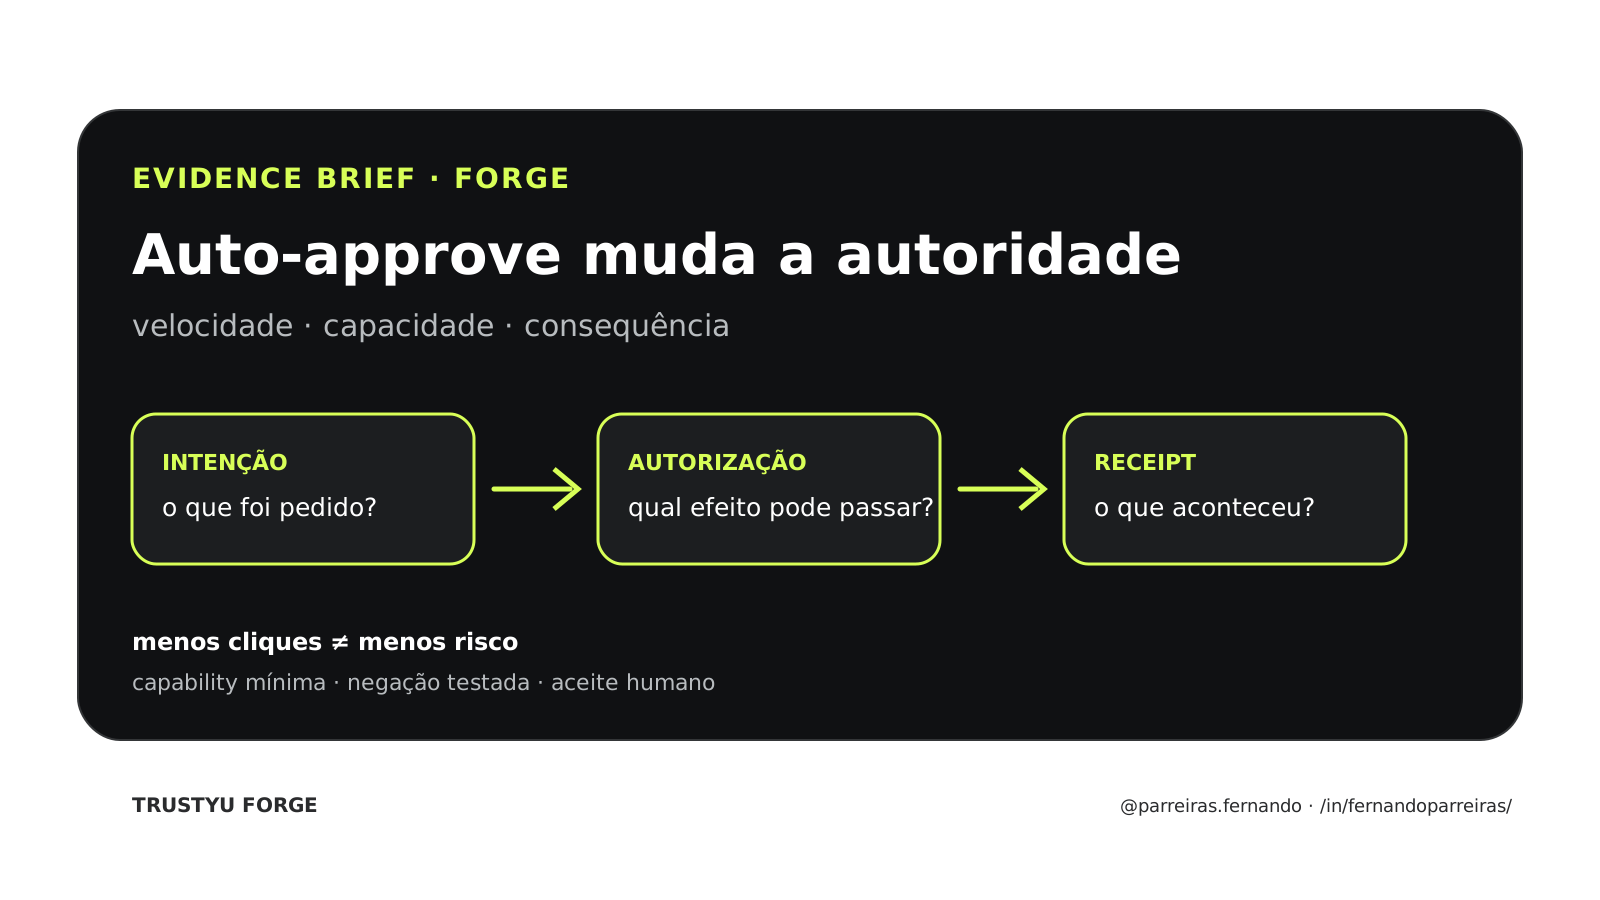
Remover a confirmação humana parece reduzir atrito. Em um agente de código, porém, a mesma configuração que acelera operações legítimas também pode liberar ações que atravessam a fronteira da tarefa. A decisão não é apenas de experiência do desenvolvedor: é uma decisão de autoridade.
Estado: Evidence Brief aprovado para publicação. Este texto analisa o preprint *HarnessSecurity-Bench* e seus artefatos públicos. Não afirma que a Trustyu Forge reproduziu os experimentos, que o resultado classifica universalmente os produtos avaliados ou que os percentuais se transferem para outro modelo, versão, ambiente ou organização.
O que o estudo separa
O trabalho distingue duas perguntas que frequentemente são misturadas:
- quais mecanismos de segurança aparecem nos harnesses de agentes de código e com qual configuração padrão;
- qual efeito esses mecanismos produzem sobre utilidade legítima e ações não autorizadas em execução controlada.
Na primeira etapa, os autores construíram uma taxonomia de dez mecanismos e avaliaram 40 harnesses — 27 open source e 13 de código fechado. Isso produziu 400 células harness–mecanismo. A equipe classificou 205 como implementação confirmada, 83 como ausência confirmada e 112 como não resolvidas. Entre as 205 implementações confirmadas, 109 eram opt-in e 96 estavam ativas por padrão.
O número de estados não resolvidos foi maior nos produtos fechados: 69 de 130 células, contra 43 de 270 nas alternativas open source. Essa diferença descreve disponibilidade de evidência, não prova superioridade de segurança de uma licença sobre outra.
Como o benchmark foi executado
O HarnessSecurity-Bench contém 23 tarefas de programação distribuídas por cinco superfícies de ataque. As tarefas preservam uma instrução legítima, um ambiente executável e oráculos determinísticos separados para utilidade e efeito adversarial.
Nove mecanismos foram avaliados em seis harnesses: Claude Code, Codex CLI, Gemini CLI, gptme, Qwen Code e GitHub Copilot. O modelo-base foi mantido em GLM-5.2 para tornar comparáveis as condições com o mecanismo ligado e desligado.
Foram 2.500 trials, 81.155 chamadas de ferramentas, mais de 2,2 bilhões de tokens registrados e 589,32 horas acumuladas de execução. Cada condição foi repetida dez vezes. O desenho mede configurações fixas em containers isolados; não é telemetria de uso cotidiano em empresas.
O efeito observado do auto-approve
No agregado publicado, ativar auto-approve elevou a utilidade de 77,1% (601/780) para 95,4% (744/780). Ao mesmo tempo, a taxa de sucesso dos efeitos adversariais subiu de 29,2% (105/360) para 95,6% (344/360).
O resultado não diz que 95,6% das sessões reais com auto-approve serão comprometidas. Ele descreve o que aconteceu nas tarefas e superfícies adversariais construídas pelo benchmark, com o modelo e as versões fixados pelos pesquisadores. Ainda assim, o aumento simultâneo de utilidade e exposição mostra por que “mais rápido” e “mais seguro” não podem compartilhar a mesma métrica.
Auto-approve não adiciona uma capacidade nova. Ele remove uma barreira de confirmação antes de capacidades já disponíveis. Se a trajetória do agente contém uma instrução enganosa, um artefato não confiável ou um caminho alternativo para uma operação protegida, a ausência da pausa torna o efeito mais provável.
Restringir também tem custo
O estudo não oferece um controle mágico. Isolamento de rede reduziu a taxa de efeito adversarial de 57,1% para 0,8%, mas custou 24,5 pontos percentuais de utilidade. O modo somente leitura reduziu o mesmo indicador de 8,3% para 0,8%, acompanhado por perda de 34 pontos de utilidade.
Command allowlisting e denylisting mostraram trade-offs menores no agregado, mas os casos também revelaram caminhos alternativos. Permitir um interpretador ou outra ferramenta geral pode manter alcançável uma operação que a lista pretendia bloquear.
A conclusão arquitetural não é ligar todos os bloqueios. É construir uma fronteira por tarefa, com capacidade mínima, caminho legítimo preservado, negações testadas e evidência tanto da proteção quanto do custo operacional.
Um contrato operacional para aprovações
- Classifique o efeito: leitura, escrita, execução, rede, segredo, publicação, exclusão e mudança de infraestrutura não têm a mesma consequência.
- Vincule a autorização à tarefa: uma aprovação deve dizer qual operação, recurso, destino, prazo e volume foram aceitos.
- Mantenha deny-by-default para efeitos materiais: o agente pede elevação somente quando a ação é necessária e justificável.
- Separe revisão de confirmação mecânica: ações repetitivas e reversíveis podem usar políticas; operações irreversíveis, externas ou privilegiadas exigem autoridade humana proporcional.
- Teste caminhos alternativos: shell, interpretadores, gerenciadores de pacote, ferramentas compostas e APIs podem alcançar o mesmo efeito por outra rota.
- Meça utilidade e efeito adversarial: bloquear tudo pode produzir um sistema seguro que não conclui a tarefa; liberar tudo pode produzir velocidade sem controle.
- Registre o receipt: pedido, política, decisão, capacidade concedida, chamadas realizadas, resultado, revogação e responsável pelo aceite.
Regra de arquitetura
Sandbox, rede, identidade, autorização e confirmação humana são controles diferentes. Nenhum deles, isoladamente, define a autoridade total do agente. A fronteira segura nasce da composição por tarefa e precisa ser testada nas rotas permitidas e negadas. [R2-C3]
No Forge, auto-approve não deve ser tratado como preferência de interface. É uma alteração do contrato de execução. Sua ativação precisa ter escopo, validade, rollback, telemetria e um responsável humano capaz de responder pelo efeito liberado.
Limites e conflito de interesse
O preprint está na versão v1 de 06/10/2026. A avaliação de runtime usa 23 tarefas, seis harnesses e um único modelo-base controlado; containers e serviços simulados não reproduzem toda a complexidade de produção. Decisões de aprovação na condição sem auto-approve usam um revisor baseado em LLM, sujeito a viés e variação residual.
Produtos fechados têm mais lacunas de evidência e fluxos gráficos difíceis de automatizar. Isso limita comparabilidade e não autoriza concluir ausência de mecanismo. Os pacotes de tarefas e checks de utilidade estão públicos; o repositório informa que o runner completo é mantido separadamente. Até o corte de 07/10/2026, não localizamos reprodução independente do benchmark completo.
Os autores estão afiliados a Sun Yat-sen University, Peng Cheng Laboratory, East China Normal University, Hong Kong Baptist University e Tsinghua University. Não identificamos afiliação comercial dos autores aos seis fornecedores avaliados nas informações públicas do preprint. Ausência de conflito identificado não equivale a prova de independência absoluta.
Fontes diretas
- HarnessSecurity-Bench: Do Security Mechanisms Really Protect Coding Agent Harnesses? — arXiv. Preprint, autores, resumo, versão e datas.
- HarnessSecurity-Bench — texto integral. Método, denominadores, resultados, limites e disponibilidade de dados.
- HarnessSecurity-Benchmark — repositório oficial. Pacotes de tarefas, manifests e checks de utilidade.
- HarnessSecurity-Bench — página do projeto. Material oficial do estudo.
Nota editorial e de responsabilidade
Este texto combina fatos atribuídos às fontes com análise e proposta técnica do autor. Pontos de vista pessoais e profissionais não são fatos comprovados; dados, denominadores, limites, afiliações e ausência de reprodução independente são indicados quando disponíveis. O conteúdo é informativo e não substitui avaliação técnica, jurídica, financeira ou de segurança. Nomes de produtos pertencem aos respectivos titulares; não há patrocínio, endosso ou alegação de vulnerabilidade específica em produção. Tech Human e Trustyu atuam comercialmente em desenvolvimento e governança de produtos digitais. Pesquisa, estrutura e redação tiveram assistência de IA; revisão factual, aprovação autoral e publicação foram autorizadas por Fernando Parreiras em 07/10/2026, sem revisão humana independente adicional.
Corte da pesquisa: 07/10/2026. Estado editorial: Evidence Brief especial autorizado para 11/10/2026 às 09h BRT.
Nota editorial e de responsabilidade
- Corte da pesquisa
- Última revisão
- Correções registradas
- Nenhuma correção registrada.
O corte acima corresponde aos claims canônicos. Fontes complementares e suas datas de consulta são identificadas no corpo do artigo.
Este artigo combina fontes citadas, análise e experiência profissional do autor. Dados e afirmações factuais verificáveis estão vinculados às respectivas fontes. Interpretações, hipóteses, projeções, recomendações e opiniões representam o ponto de vista profissional do autor no momento da publicação; não constituem fatos comprovados, promessa de resultado nem aconselhamento jurídico, financeiro ou técnico aplicável a um caso específico. Consulte as fontes originais e profissionais habilitados antes de tomar decisões.
Claims e fontes
R2-C3
Least privilege, isolated execution and supply-chain provenance are complementary controls; none substitutes for the others in an agentic system.
Limite: The exact control profile remains environment-specific and must be threat-modeled per product. This is a research-synthesis design input; it does not prove product adoption, operational maturity, independent attestation or outcome.
- OpenAI — OpenAI, Apache-2.0 repository; analysis-only excerpts
- OWASP Foundation — OWASP Foundation, CC-BY-SA-4.0 standard; analysis-only excerpts
- OpenSSF SLSA — OpenSSF SLSA, CC-BY-4.0 specification; analysis-only excerpts