Leitura executiva · ~60 segundos
BlueCodeAgent transforma exemplos produzidos por red teaming em conhecimento de defesa e, no caso de código vulnerável, combina análise estática com testes executáveis em sandbox. O paper final reporta ganho médio de 14,7% em F1 com GPT-4o, mas o resultado permanece restrito aos benchmarks estudados. A decisão de arquitetura é separar geração, conhecimento adversarial, execução de testes, decisão de release e responsabilidade humana.
Um modelo pode ler código, reconhecer padrões de vulnerabilidade e ainda errar de duas formas opostas: deixar passar algo perigoso ou bloquear código seguro por excesso de cautela. O BlueCodeAgent, publicado nos anais finais da ICML 2026, propõe uma arquitetura para reduzir essa distância.
O ponto mais importante não é trocar um revisor humano por outro modelo. É transformar conhecimento acumulado por red teaming em contexto de defesa e, quando a propriedade admite execução, exigir evidência dinâmica antes da decisão.
Estado: Evidence Brief aprovado para publicação. Este texto analisa o paper e o repositório público. Não afirma que a Trustyu Forge reproduziu os experimentos, que o sistema está implantado em produtos Trustyu ou que o resultado se transfere automaticamente para produção.
O resultado final — e a divergência entre páginas
Nos anais finais da ICML 2026, os autores avaliam quatro tarefas: detecção de instruções com viés, instruções maliciosas, código vulnerável e prompt injection. Com GPT-4o como modelo-base, o resumo final reporta melhora média de 14,7% em F1 sobre prompting direto nas quatro tarefas. [BLUECODE-C1]
A página da Microsoft Research ainda apresenta uma versão anterior: 12,7% de melhora, quatro datasets e três tarefas. Esta análise adota o registro final dos proceedings — 14,7% e quatro tarefas — e mantém a divergência documentada para não misturar versões do estudo.
F1 combina precisão e recall. Uma melhora relativa ou em pontos de F1 não informa, sozinha, quantos incidentes seriam evitados em produção. O denominador, a distribuição das classes, os baselines e o custo de falsos positivos precisam acompanhar o número.
Como o BlueCodeAgent organiza a defesa
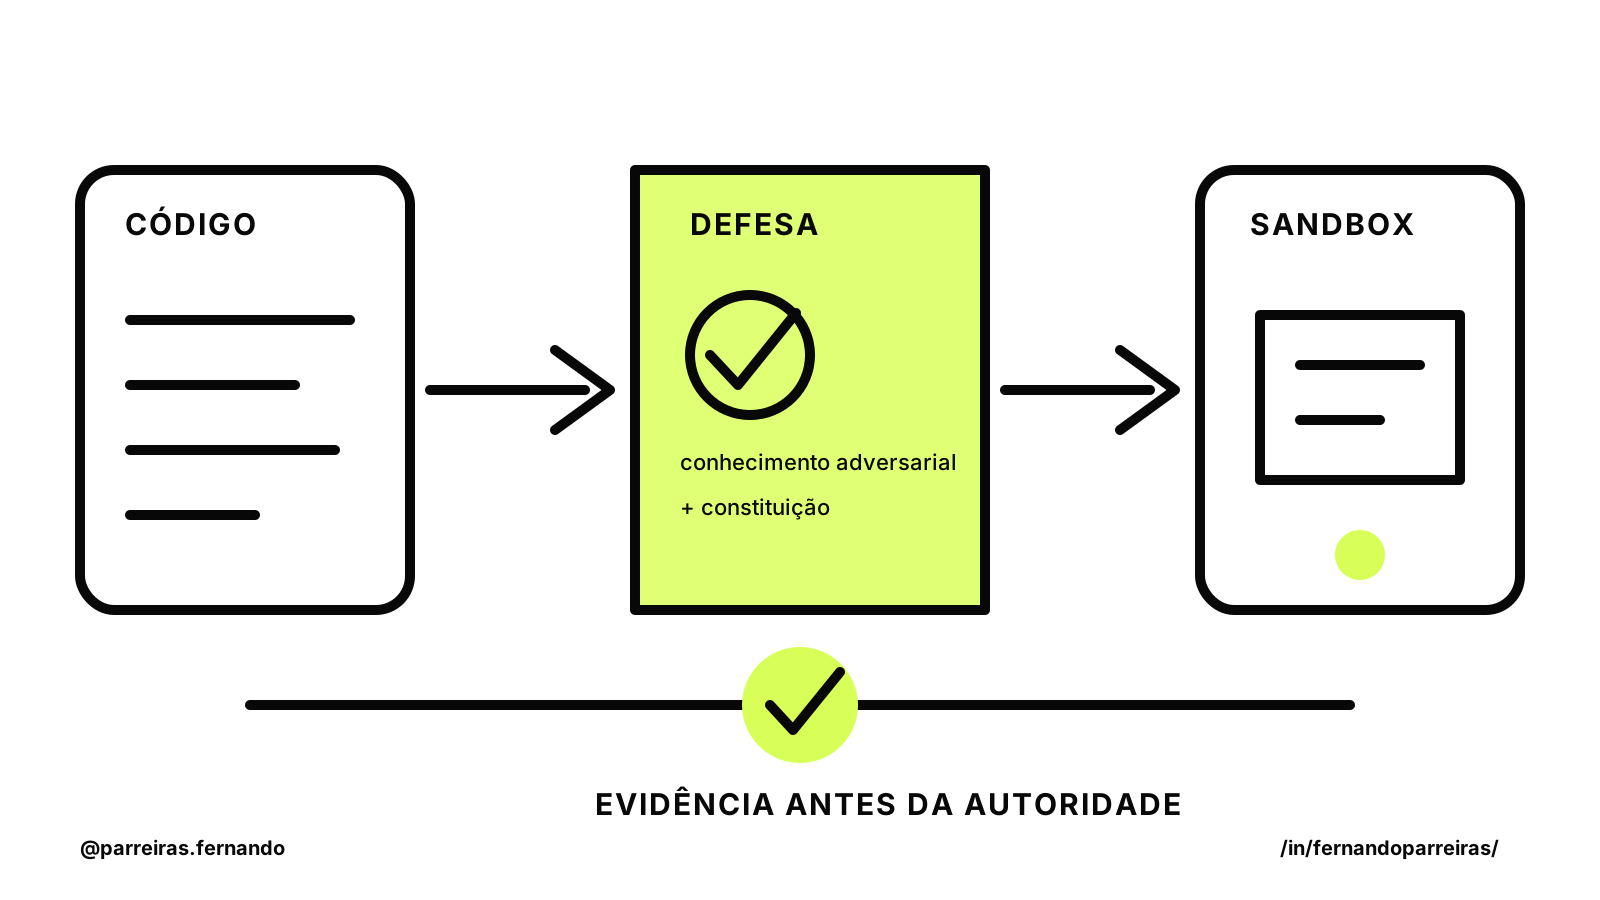
O repositório oficial descreve três camadas. Primeiro, o sistema recupera exemplos semelhantes de uma base construída por red teaming automatizado. Depois, um modelo resume esse material em constituições acionáveis para orientar a classificação. Por fim, na tarefa de código vulnerável, uma análise estática propõe a falha, um componente gera testes executáveis, a sandbox roda os testes e uma etapa final combina raciocínio, resultados e constituição.
Esse desenho separa funções que frequentemente aparecem misturadas em um único prompt:
- Descoberta adversarial: produzir casos difíceis e registrar como a defesa falhou.
- Memória de risco: conservar exemplos, proveniência, categoria e contexto.
- Princípios de decisão: converter exemplos recuperados em critérios aplicáveis ao caso atual.
- Análise de artefato: examinar instrução ou código sem executar efeitos no ambiente real.
- Validação dinâmica: gerar e executar testes em uma sandbox restrita quando isso reduz ambiguidade.
- Autoridade: decidir se o finding bloqueia, pede revisão ou permite avançar.
A arquitetura não elimina julgamento. Ela torna mais explícito onde cada tipo de evidência nasce e qual componente tem autoridade para produzir efeito.
Conhecimento adversarial precisa ser governado
Uma base de red teaming envelhece. Ataques mudam, bibliotecas mudam, modelos mudam e exemplos podem carregar dados perigosos, licenças restritivas ou instruções que não deveriam alcançar todo executor. Recuperação sem governança pode melhorar um benchmark e ampliar a superfície de exposição.
Um contrato mínimo para essa memória inclui:
| Campo | Pergunta de controle |
|---|---|
source | De onde veio o caso e qual uso é permitido? |
risk_class | Que propriedade de segurança ele representa? |
affected_surface | Qual linguagem, biblioteca, ferramenta ou modelo está no escopo? |
observed_at | Quando a falha foi observada? |
evidence | Que artefato permite reconstruir o finding? |
review_after | Quando o caso precisa ser revalidado? |
access_policy | Quem pode recuperar o conteúdo e com qual finalidade? |
A recuperação também precisa registrar quais exemplos influenciaram a decisão. Sem isso, uma constituição gerada é uma explicação plausível, mas não uma trilha reproduzível.
Validação dinâmica não é executar código livremente
O ganho da análise dinâmica vem com uma condição: o código potencialmente hostil precisa executar em uma fronteira criada para falhar. Rede negada por padrão, sistema de arquivos efêmero, credenciais ausentes, limites de CPU e memória, timeout, imagem pinada, registro externo e descarte verificável são requisitos do harness, não detalhes de implementação.
O próprio repositório usa Docker para a tarefa de vulnerabilidade. Isso é evidência de uma implementação de pesquisa, não certificação de isolamento. Contêiner não deve ser tratado como sinônimo de sandbox suficiente para qualquer adversário. A organização precisa modelar ameaça, testar escapes relevantes e definir o que acontece quando o verificador trava, diverge ou não consegue executar o caso.
Um gate técnico para revisão de código por IA
Antes de permitir que um revisor de IA influencie merge ou release, a equipe pode exigir:
- O finding identifica arquivo, linha, propriedade violada e evidência reproduzível?
- O classificador foi medido no tipo de código, linguagem e distribuição relevantes?
- Falso positivo, falso negativo e inconclusão são estados separados?
- Testes dinâmicos rodam fora do ambiente de desenvolvimento e sem credenciais úteis?
- A base adversarial tem origem, licença, validade, controle de acesso e versionamento?
- O artefato avaliado está ligado ao commit e ao digest que será promovido?
- Regras protegidas impedem o próprio agente de dispensar checks ou alterar o gate?
- Uma pessoa accountable aprova o risco residual proporcional à consequência?
O output útil não é “seguro”. É um pacote composto por finding, evidência, limitações, versão dos componentes, resultado dos testes e decisão de autoridade.
O que o paper prova — e o que não prova
O paper fornece evidência experimental de que a combinação proposta superou os baselines estudados nos benchmarks reportados. O código e parte dos dados estão públicos, o que melhora a possibilidade de inspeção e reprodução. Os subconjuntos de código malicioso permanecem sob acesso controlado, conforme as licenças e o impacto descritos pelos autores.
Isso não equivale a uma replicação independente completa. O estudo não mede operação contínua em repositórios empresariais, latência e custo em escala, impacto sobre desenvolvedores, resistência a adaptação adversarial prolongada, cobertura de linguagens reais ou redução de incidentes depois do deploy.
Também não autoriza transformar 14,7% em promessa comercial. A métrica é uma média em condições experimentais com GPT-4o como base. Outro modelo, outra base de risco, outro balanceamento ou outra política de decisão pode produzir resultado diferente.
Limitações, contrapontos e conflitos
- O paper e o repositório são produzidos pelos autores do método; não foi localizada, no corte de 01/10/2026, uma reprodução completa e independente dos resultados finais.
- A base usa conhecimento derivado de red teaming; seu desempenho depende da proximidade entre os riscos recuperados e os casos avaliados.
- Análise dinâmica aparece especificamente na tarefa de código vulnerável, não como mecanismo universal para as quatro tarefas.
- A divulgação pública do repositório melhora a auditabilidade, mas parte dos dados maliciosos é restrita e a reprodução integral exige modelos, chaves, Docker e condições compatíveis.
- A página da Microsoft Research e o proceedings final divergem em tarefas e ganho médio; o registro final de conferência prevalece nesta versão.
- Os controles deste brief são uma proposta profissional derivada das evidências, não resultados causais medidos pelo paper.
Fontes diretas
- PMLR — BlueCodeAgent: A Blue Teaming Agent Powered by Automated Red Teaming for CodeGen AI. Registro final nos Proceedings of the 43rd ICML, quatro tarefas e 14,7% de melhora média em F1 com GPT-4o.
- Repositório oficial BlueCodeAgent. Implementação, estrutura de dados, scripts de avaliação, sandbox e limites de acesso aos subconjuntos maliciosos.
- Microsoft Research — BlueCodeAgent. Página institucional que ainda apresenta 12,7% e três tarefas; mantida como registro da divergência de versão.
Nota editorial e de responsabilidade
Este texto combina fatos atribuídos às fontes com análise e proposta técnica do autor. Pontos de vista pessoais e profissionais não são fatos comprovados; dados, denominadores, limites e conflitos são indicados quando disponíveis. O conteúdo é informativo e não substitui avaliação técnica, jurídica, financeira ou de segurança. Tech Human e Trustyu atuam comercialmente em temas relacionados. Pesquisa, estrutura e redação tiveram assistência de IA; revisão factual, aprovação autoral e publicação foram confirmadas por Fernando Parreiras em 01/10/2026, sem revisão humana independente adicional.
Corte da pesquisa: 01/10/2026. Estado editorial: Evidence Brief especial autorizado para 02/10/2026 às 13h30 BRT.
Nota editorial e de responsabilidade
- Corte da pesquisa
- Última revisão
- Correções registradas
- Nenhuma correção registrada.
O corte acima corresponde aos claims canônicos. Fontes complementares e suas datas de consulta são identificadas no corpo do artigo.
Este artigo combina fontes citadas, análise e experiência profissional do autor. Dados e afirmações factuais verificáveis estão vinculados às respectivas fontes. Interpretações, hipóteses, projeções, recomendações e opiniões representam o ponto de vista profissional do autor no momento da publicação; não constituem fatos comprovados, promessa de resultado nem aconselhamento jurídico, financeiro ou técnico aplicável a um caso específico. Consulte as fontes originais e profissionais habilitados antes de tomar decisões.
Claims e fontes
BLUECODE-C1
In the final ICML proceedings, BlueCodeAgent with GPT-4o reports a 14.7% average F1 improvement across four benchmark tasks over direct prompting, combining retrieved red-team knowledge with constitution summarization and dynamic analysis for the vulnerable-code task.
Limite: The 14.7% figure is an average F1 improvement reported in the final ICML proceedings for GPT-4o across four benchmark tasks relative to direct prompting. It is not a production incident rate, universal model ranking, independent replication, or proof that the system prevents unsafe code in real repositories.
- BlueCodeAgent: A Blue Teaming Agent Powered by Automated Red Teaming for CodeGen AI — Proceedings of Machine Learning Research, PMLR publication terms; bibliographic and abstract-level synthesis
- Official BlueCodeAgent implementation — BlueCodeAgent authors, MIT for code; dataset-specific terms and gated subsets apply