Leitura executiva · ~60 segundos
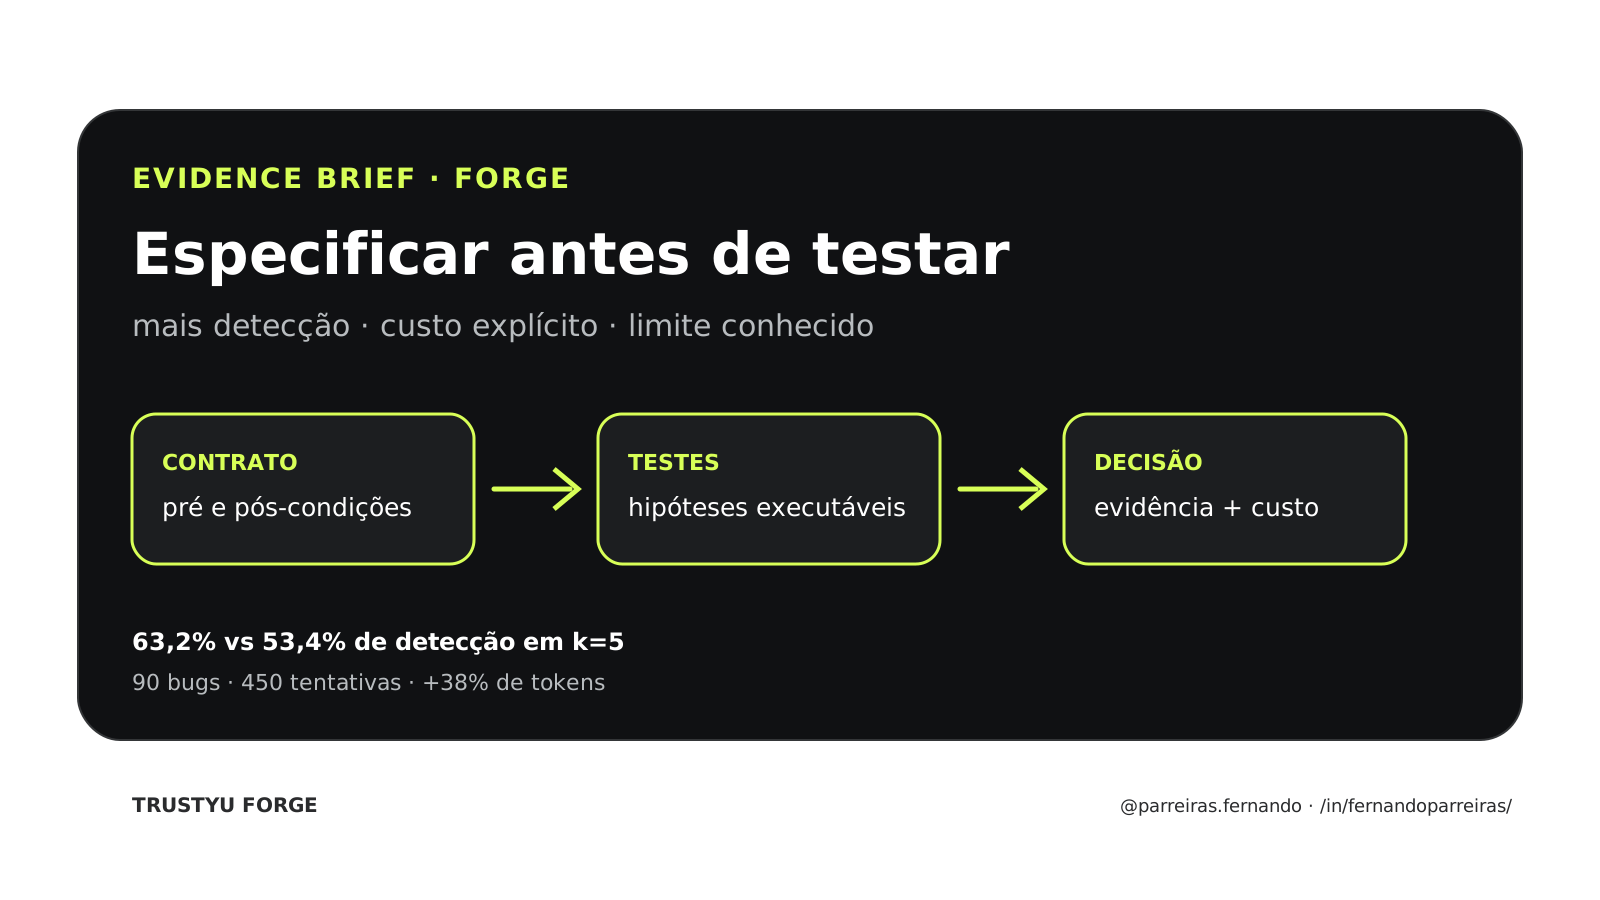
Em 90 bugs históricos de produção do Google, um agente que escreveu contratos antes de gerar testes detectou 63,2% dos defeitos em cinco tentativas, contra 53,4% no baseline. O ganho de 9,8 pontos percentuais veio com 38% mais tokens. O estudo sustenta contratos como etapa útil de raciocínio e controle, não como substituto de cobertura, revisão ou decisão humana.
Um agente pode gerar muitos testes e ainda não tocar a propriedade que distingue comportamento correto de um defeito. O problema não é apenas escrever código de teste. É explicitar o contrato que o sistema deveria preservar antes de escolher entradas e oráculos.
Estado: Evidence Brief aprovado para publicação. Este texto analisa um estudo com bugs históricos internos do Google. Não afirma que a Trustyu Forge reproduziu os experimentos nem que os resultados se transferem automaticamente para outro stack, modelo ou organização.
O experimento
O paper *Grounding AI Agents in Contracts* avaliou 90 bugs históricos de produção, todos com correções em um único arquivo, em C++, Java, Python e Go. O mesmo modelo — Gemini 3 Flash — recebeu até cinco tentativas por bug, totalizando 450 execuções por abordagem. No baseline, o agente gerava testes diretamente. Na condição spec-driven, primeiro escrevia pré-condições, pós-condições e sugestões de teste em linguagem natural; depois usava esse contrato para produzir a suíte.
A curadoria humana opcional proposta pela arquitetura foi deliberadamente retirada do experimento. Isso permite medir a contribuição da etapa de especificação, mas não mede um fluxo completo de engenharia com especialistas revisando o contrato.
O ganho, com denominador
Em cinco tentativas, a abordagem orientada por contrato detectou 63,2% dos 90 bugs, contra 53,4% no baseline — diferença de 9,8 pontos percentuais, reportada com p=0,0352. Foram 57 bugs encontrados pela abordagem spec-driven e 48 pelo baseline: 45 em comum, 12 exclusivos da especificação e três exclusivos do baseline.
A cobertura de branches subiu de 46,4% para 48,9%, diferença de 2,5 pontos; a variação de cobertura de linhas foi de -0,4 ponto e não foi estatisticamente significativa. Isso importa porque mais detecção não veio simplesmente de executar muito mais linhas. O contrato parece ter orientado quais comportamentos procurar.
Quando a suíte cobriu o contrato produzido, a detecção ocorreu em 54,9% das tentativas, 151 de 275. Sem cobertura do contrato, ocorreu em 19,4%, 34 de 175. É uma associação forte dentro do experimento, não prova causal universal.
O custo que não deve ser escondido
O baseline consumiu 243,9 milhões de tokens. A abordagem spec-driven consumiu 336,7 milhões: 38% a mais. A entrada cresceu 36,2% e a saída 59,1%. Por bug exclusivo encontrado, o custo estimado passou de 5,1 milhões para 5,9 milhões de tokens, aumento de 16,2%.
Esse número muda a decisão operacional. Melhor detecção pode justificar mais inferência em software crítico, mas não em qualquer mudança. A política precisa definir quando o contrato adicional é obrigatório, quando um template mais simples basta e quando o custo não se paga.
Como transformar o achado em um gate
- Declare a propriedade: registre pré-condições, pós-condições, invariantes e comportamentos proibidos antes de pedir testes.
- Separe contrato de implementação: o oráculo deve observar comportamento, não copiar a correção conhecida.
- Meça cobertura do contrato: cobertura de linha e branch continua útil, mas não informa sozinha se a propriedade crítica foi exercitada.
- Preserve divergência: se teste direto e teste orientado por contrato encontram conjuntos diferentes de bugs, use diversidade em vez de escolher um único agente.
- Orce a inferência: registre tokens, latência e custo por defeito adicional detectado.
- Vincule ao artefato: contrato, suíte, resultado, modelo, prompt e commit precisam formar uma trilha reproduzível.
- Mantenha decisão humana: um teste que falha é evidência a investigar; um teste que passa não certifica o sistema inteiro.
O que o estudo não prova
A amostra vem de um único monorepo e de um processo interno do Google. Os bugs são históricos, a correção toca um arquivo e o experimento usa uma família de modelos. Sistemas distribuídos, falhas de configuração, identidade, concorrência, dependências e incidentes emergentes podem responder de outra forma.
A avaliação de qualidade das suítes também usou Gemini 3.1 Pro como juiz. O estudo anonimizou e randomizou a ordem e repetiu o julgamento cinco vezes, mas um avaliador LLM pode carregar ruído, preferência de estilo ou afinidade com a mesma família tecnológica. A preferência de 77,8% sobre o baseline e 56,7% sobre testes humanos, entre 83 testes gerados com sucesso, não equivale a superioridade geral sobre especialistas.
Todos os autores são ligados ao Google. Isso não invalida o trabalho, mas torna afiliação, acesso ao dataset interno e ausência de reprodução independente relevantes para a leitura. Até o corte de 04/10/2026, não localizamos replicação externa do experimento completo.
Regra de arquitetura
Especificação não é documentação escrita depois. É um intermediário verificável entre intenção e execução. Quando um agente precisa declarar o contrato antes do teste, a equipe ganha um objeto que pode revisar, versionar, comparar e usar para explicar por que aquela suíte deveria detectar determinada classe de erro. [HARNESS31-C2]
O resultado útil não é ‘a IA testou’. É: qual propriedade foi declarada, qual evidência a exercitou, qual custo foi consumido, o que permaneceu fora do escopo e quem autorizou o risco residual.
Fontes diretas
- Grounding AI Agents in Contracts: An Empirical Evaluation of Spec-Driven Test Generation — arXiv. Preprint, método, amostra, tabelas e limitações.
- DOI ACM do artigo. Registro persistente da publicação.
Nota editorial e de responsabilidade
Este texto combina fatos atribuídos às fontes com análise e proposta técnica do autor. Pontos de vista pessoais e profissionais não são fatos comprovados; dados, denominadores, limites e conflitos são indicados quando disponíveis. O conteúdo é informativo e não substitui avaliação técnica, jurídica, financeira ou de segurança. Tech Human e Trustyu atuam comercialmente em temas relacionados. Pesquisa, estrutura e redação tiveram assistência de IA; revisão factual, aprovação autoral e publicação foram confirmadas por Fernando Parreiras em 04/10/2026, sem revisão humana independente adicional.
Corte da pesquisa: 04/10/2026. Estado editorial: Evidence Brief especial autorizado para 06/10/2026 às 09h BRT.
Nota editorial e de responsabilidade
- Corte da pesquisa
- Última revisão
- Correções registradas
- Nenhuma correção registrada.
O corte acima corresponde aos claims canônicos. Fontes complementares e suas datas de consulta são identificadas no corpo do artigo.
Este artigo combina fontes citadas, análise e experiência profissional do autor. Dados e afirmações factuais verificáveis estão vinculados às respectivas fontes. Interpretações, hipóteses, projeções, recomendações e opiniões representam o ponto de vista profissional do autor no momento da publicação; não constituem fatos comprovados, promessa de resultado nem aconselhamento jurídico, financeiro ou técnico aplicável a um caso específico. Consulte as fontes originais e profissionais habilitados antes de tomar decisões.
Claims e fontes
HARNESS31-C2
A durable harness should keep session history, orchestration policy and execution isolation as explicit boundaries, while adapters and plugins prevent model or channel choice from becoming the security boundary.
Limite: The sources show two implementations, not a neutral interoperability standard. Actual permissions must be independently enforced and tested outside model choice. This is a source-bound design input; it does not prove product adoption, operational maturity, independent attestation, search ranking, AI citation or outcome.
- Anthropic — Anthropic, proprietary-site-terms
- YC Software — YC Software, MIT
- YC Software — YC Software, MIT