
Leitura executiva · ~60 segundos
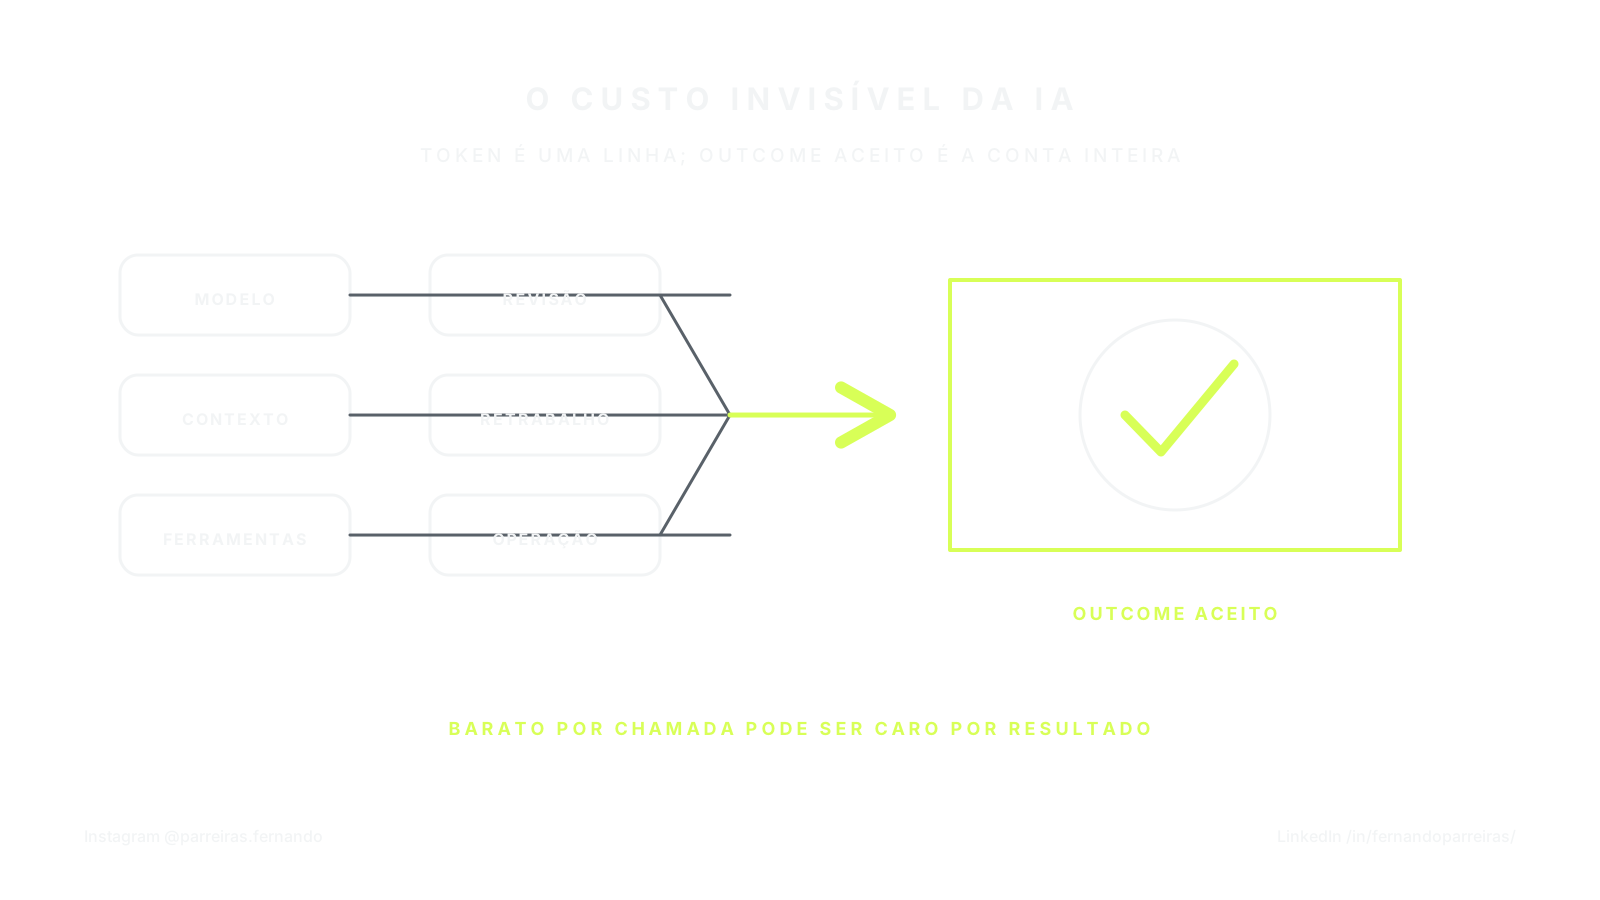
A inferência ficou dramaticamente mais barata, mas o custo migrou para contexto, ferramentas, harness, CI, evals, operação, trabalho humano e falhas. O denominador correto é outcome aceito.
Entre novembro de 2022 e outubro de 2024, o custo de inferência de um sistema no nível do GPT-3.5 caiu mais de 280 vezes, segundo o AI Index 2025 de Stanford. Estudos posteriores da Epoch AI também encontram quedas rápidas quando preço e desempenho são comparados juntos, embora a taxa varie muito por benchmark. Essa transformação é real. A conclusão de que produtos de IA ficaram baratos, porém, não decorre dela.
O preço do modelo é apenas a primeira linha de uma cadeia que passa por contexto, ferramentas, orquestração, evals, CI, observabilidade, segurança, intervenção humana, incidentes e aprendizado. À medida que a inferência barateia, a parcela relativa dessas outras contas cresce. O gargalo muda de lugar.
Resumo executivo
O denominador útil não é chamada, token ou tarefa iniciada. É o outcome aceito:
modelos + dados/contexto + ferramentas + execução/CI + verificação
+ operação + trabalho humano + falhas + evolução
---------------------------------------------------------------
outcomes aceitos
Essa fórmula não é um standard contábil. É um contrato de observabilidade para impedir que a economia de uma camada seja celebrada enquanto custo, risco ou retrabalho migram para outra.
A cadeia completa
1. Inferência: a linha visível
Tokens, imagens, áudio, cache, batch, reasoning e chamadas repetidas continuam relevantes. Quedas de preço não são uniformes entre qualidade, modalidade, latência ou janela de contexto. Compare modelos na mesma tarefa, com o mesmo critério de aceite e o mesmo período; não transforme um benchmark em fatura futura.
2. Dados e contexto: o que alimenta a decisão
Documentos precisam ser descobertos, autorizados, limpos, versionados, indexados e retirados quando expiram. Retrieval barato com fonte errada produz uma resposta barata e uma decisão cara. Custos de licenciamento, qualidade, privacidade e governança pertencem à mesma unidade econômica.
3. Ferramentas e integrações: cada ação amplia a superfície
Busca, bancos, navegadores, filas, storage e APIs cobram dinheiro e complexidade. Um agente pode executar muitas operações para concluir uma entrega. O AWS Agentic AI Lens alerta que loops de planejar, agir, verificar e refletir, além de coordenação multiagente, podem aumentar consumo, latência e invocações de ferramentas. Um limite de custo sem condição de parada é apenas um alerta tardio.
4. Harness e orquestração: o trabalho de tornar capacidade repetível
Prompts são uma peça. Estado, identidade, capabilities, roteamento, políticas, memória, sandbox, timeouts, retries e handoffs formam o sistema. A recomendação da Anthropic é começar por padrões simples e acrescentar agenticidade apenas quando ela melhora materialmente o resultado, porque autonomia troca previsibilidade e latência por desempenho em tarefas adequadas.
O harness também acumula conhecimento experimental: qual modelo funciona para cada classe de tarefa, que contexto é suficiente, quais verificadores detectam falhas e quando escalar. Calibrá-lo é investimento; mantê-lo é custo recorrente.
5. Evals e verificação: transformar produção em confiança
Agentes são mais difíceis de avaliar porque escolhem caminhos, usam ferramentas e alteram estado. O guia de evals da Anthropic recomenda conjuntos de tarefas, graders e análise de transcrições; essas medições também criam baselines para latência, tokens, custo por tarefa e tipos de erro.
Remover evals faz a conta parecer menor porque deixa de medir a falha. Evals demais, mal escolhidos, criam CI lenta e cara. O objetivo é cobertura proporcional ao risco, com amostragem, tiers e gates determinísticos antes de árbitros mais caros.
6. CI e infraestrutura: o imposto da mudança frequente
Cada alteração em prompt, modelo, ferramenta, policy, dataset ou dependência pode exigir testes, build, ambientes efêmeros, scanners, runners, storage e repetição. Sistemas AI-native elevam a taxa de mudança e o número de configurações possíveis. Sem seleção de testes por risco, cache seguro, concorrência controlada e ambientes com prazo de expiração, o custo de provar uma mudança pode superar o custo de executá-la.
Esse é um sinal de maturidade, não um argumento para eliminar CI. A pergunta é: qual evidência deve ser produzida para esta classe de mudança, e qual execução duplicada não acrescenta confiança?
7. Operação e segurança: o sistema depois do deploy
Gateway, observabilidade, egress, secrets, identidade, rate limits, isolamento, retenção, suporte e recuperação não aparecem na demo. O NIST AI RMF e seu perfil para IA generativa tratam medição, monitoramento e gestão de risco como trabalho contínuo. Não há economia sustentável quando logs, controles ou rollback são removidos para reduzir a fatura corrente.
8. Trabalho humano: a conta que costuma desaparecer
Pessoas preparam casos, revisam exceções, explicam decisões, recuperam falhas e atendem clientes. O State of FinOps 2026 informa que 98% dos respondentes já gerenciam gasto com IA, mas somente 28% incluem trabalho na conta. O levantamento cobre 1.192 profissionais e mais de US$ 83 bilhões em gasto anual de cloud representado; é um retrato da comunidade FinOps, não de todas as empresas.
Revisão humana não é automaticamente desperdício. Pode ser o controle correto. Ela precisa aparecer por classe de tarefa e consequência para que preço, margem e automação sejam decisões honestas.
9. Falha, retrabalho e dívida: custos que chegam depois
Uma saída rejeitada consome todas as camadas anteriores e não entra no denominador. Incidentes ainda somam investigação, contenção, comunicação, rollback e confiança. O paper *Hidden Technical Debt in Machine Learning Systems* mostrou há mais de uma década que ganhos rápidos de ML podem carregar custos de manutenção por dependências de dados, feedback loops, configuração e erosão de fronteiras. LLMs mudaram a interface; não eliminaram essa dinâmica.
10. Energia e capacidade: a conta sistêmica
A IEA estima que o consumo elétrico global de data centers passe de cerca de 485 TWh em 2025 para aproximadamente 950 TWh em 2030, com forte participação da IA. Esse cenário não deve ser atribuído linearmente a uma chamada ou produto. Ele mostra que energia, rede, chips, localização e prazo de capacidade podem reaparecer como preço, limite e risco de supply chain.
Quatro decisões de engenharia que mudam a curva
Roteie por tarefa, não por prestígio
FrugalGPT e RouteLLM mostram, em benchmarks e configurações específicas, que cascatas e roteamento podem reduzir custo preservando qualidade. Os resultados não são garantia de produção. O padrão transferível é manter um conjunto de casos, um critério de aceite e um fallback, e promover a rota mais barata que passa no gate.
Coloque condições de parada no orçamento
Limites de turnos, tempo, tokens, chamadas, mutação e custo devem gerar stop, escalate ou inconclusive; nunca um pass por exaustão. Orçamento é uma propriedade do contrato de execução, não um painel observado depois.
Meça goodput, não atividade
Throughput conta tentativas. Goodput conta resultados válidos dentro de qualidade e latência. A FinOps Foundation propõe ligar tokens, inferência e workflow ao custo por outcome. Na FORGE, o equivalente é preservar um receipt que associe versão, custo, verificador e aceite. Observabilidade deve chegar a uma unidade de valor e seu custo, não parar no recurso técnico. [R3-C2]
Trate CI como portfólio de evidências
Organize suites em camadas: contratos determinísticos e rápidos; integração seletiva; evals por amostragem; red team e ensaios prolongados em cadência própria. Registre taxa de falha, flakiness, tempo, custo e bugs detectados por suite. Desligar um teste requer evidência de redundância ou irrelevância, não apenas uma fatura alta.
O painel mínimo por outcome
| Dimensão | Pergunta | Sinal mínimo |
|---|---|---|
| Valor | o resultado foi aceito e utilizado? | outcomes aceitos / iniciados |
| Qualidade | o que falhou e onde foi detectado? | erro por classe e gate |
| Modelo | quanto foi consumido para as saídas aceitas? | custo de inferência / outcome |
| Plataforma | que recursos sustentaram o fluxo? | compute, storage, rede e ferramentas |
| Evidência | quanto custou provar a mudança? | CI + evals + revisão por release |
| Pessoas | onde intervenção foi necessária? | minutos e motivo por classe |
| Falha | qual custo escapou do fluxo normal? | retrabalho, incidentes e recuperação |
Não use zero quando o dado não existe. Use unknown, declare o método de alocação e reconcilie estimativa com as interfaces oficiais de cobrança. Estimativa de token não substitui invoice. [R3-C3]
O que pode vir depois
Cinco pressões tendem a ganhar importância:
- Custo de provas. Mais autonomia exigirá mais evidência de autorização, procedência e verificação; a prova poderá se tornar uma classe explícita de infraestrutura.
- Volatilidade de margem. Preço por outcome transfere para o fornecedor o risco de retries, exceções e mudanças de modelo; gross margin precisará ser observada por coorte e tarefa.
- Escassez localizada. Energia, chips, rede, residência de dados e janelas de capacidade podem limitar expansão mesmo quando o preço nominal do modelo cai.
- Dívida de avaliação. Suites envelhecem, datasets deixam de representar uso e graders podem compartilhar os vieses do gerador. Manter a medição será produto interno contínuo.
- Portabilidade econômica. Trocar modelo será simples no diagrama e caro no comportamento: prompts, ferramentas, latência, segurança e taxa de aceite precisarão ser recalibrados.
Essas são hipóteses de planejamento, não previsões confirmadas. O propósito é torná-las observáveis antes que virem surpresa financeira.
Um plano de 30 dias
- escolha um fluxo com volume, dono e critério de aceite;
- registre baseline de custo, latência, retrabalho e intervenção;
- atribua tags de versão, modelo, tarefa, cliente/coorte e ambiente;
- some modelo, plataforma, ferramentas, CI/evals e tempo humano;
- divida por outcomes aceitos, preservando
unknown; - encontre as duas maiores parcelas e as duas maiores causas de rejeição;
- execute uma mudança por vez e compare com o mesmo conjunto de casos;
- mantenha qualidade, risco e margem como guardrails simultâneos.
Limites e conflitos de interesse
- Stanford, Epoch AI, METR, FrugalGPT e RouteLLM estudam períodos, tarefas e benchmarks diferentes; nenhum número deve ser projetado diretamente para uma empresa.
- O estudo da METR encontrou desaceleração de 19% em 246 tarefas realizadas por 16 desenvolvedores experientes em repositórios open source maduros. É evidência importante contra generalizações, não uma estimativa universal de produtividade.
- AWS, Anthropic e Stripe são fornecedores com interesse comercial nas categorias que descrevem.
- Bessemer é investidora; suas referências de margem são tese de mercado, não auditoria independente.
- IEA descreve infraestrutura global; não atribui consumo a este artigo, à FORGE ou a um produto.
- Trustyu e Tech Human atuam comercialmente em arquitetura, governança e construção de produtos de IA.
Fontes diretas
- Stanford HAI — AI Index Report 2025.
- Epoch AI — LLM inference price trends.
- FinOps Foundation — State of FinOps 2026.
- FinOps Foundation — FinOps for AI.
- AWS — Agentic AI Lens: Cost Optimization.
- Anthropic — Building effective agents.
- Anthropic — Demystifying evals for AI agents.
- Sculley et al. — Hidden Technical Debt in Machine Learning Systems.
- NIST — Generative AI Profile, NIST AI 600-1.
- IEA — Key questions on energy and AI.
- Chen et al. — FrugalGPT.
- Ong et al. — RouteLLM.
- METR — Measuring the Impact of Early-2025 AI on Experienced Open-Source Developer Productivity.
- DORA — State of AI-assisted Software Development 2025.
Nota editorial e de responsabilidade
Dados e conclusões foram ligados às fontes indicadas e lidos com seus recortes. A cadeia de custos, o painel e o plano de 30 dias são síntese profissional do autor, não standard contábil, promessa de economia nem alegação sobre custos privados da Trustyu. O conteúdo é informativo e não substitui avaliação financeira, técnica, jurídica ou de segurança. Pesquisa e redação tiveram assistência de IA; revisão factual, autoria e aprovação de publicação pertencem a Fernando Parreiras. Não houve revisão humana independente adicional.
Nota editorial e de responsabilidade
- Corte da pesquisa
- Última revisão
- Correções registradas
- Nenhuma correção registrada.
O corte acima corresponde aos claims canônicos. Fontes complementares e suas datas de consulta são identificadas no corpo do artigo.
Este artigo combina fontes citadas, análise e experiência profissional do autor. Dados e afirmações factuais verificáveis estão vinculados às respectivas fontes. Interpretações, hipóteses, projeções, recomendações e opiniões representam o ponto de vista profissional do autor no momento da publicação; não constituem fatos comprovados, promessa de resultado nem aconselhamento jurídico, financeiro ou técnico aplicável a um caso específico. Consulte as fontes originais e profissionais habilitados antes de tomar decisões.
Claims e fontes
R3-C2
Useful AI observability must connect technical telemetry to a unit of value and its cost, instead of optimizing aggregate spend without an outcome denominator.
Limite: A unit must be product-specific; this framework-only run measures intake cost but not customer outcome. This is a research-synthesis design input; it does not prove product adoption, operational maturity, independent attestation or outcome.
- OpenTelemetry — OpenTelemetry, CC-BY-4.0 documentation; analysis-only excerpts
- FinOps Foundation — FinOps Foundation, CC-BY-4.0 framework; analysis-only excerpts
R3-C3
Financial reconciliation should use official provider usage or cost interfaces and preserve unknown as unknown; token estimates are not an invoice substitute.
Limite: No provider admin credential or nonzero model call was used in this framework-only run, so live model spend remains not configured rather than zero. This is a research-synthesis design input; it does not prove product adoption, operational maturity, independent attestation or outcome.
- OpenAI — OpenAI, Apache-2.0 SDK documentation; analysis-only excerpts
- Anthropic — Anthropic, MIT repository; analysis-only excerpts
- Google Cloud — Google Cloud, Apache-2.0 official Google Cloud blueprint; analysis-only excerpts
- GitHub — GitHub, CC-BY-4.0 documentation; analysis-only excerpts