
Lectura ejecutiva · ~60 segundos
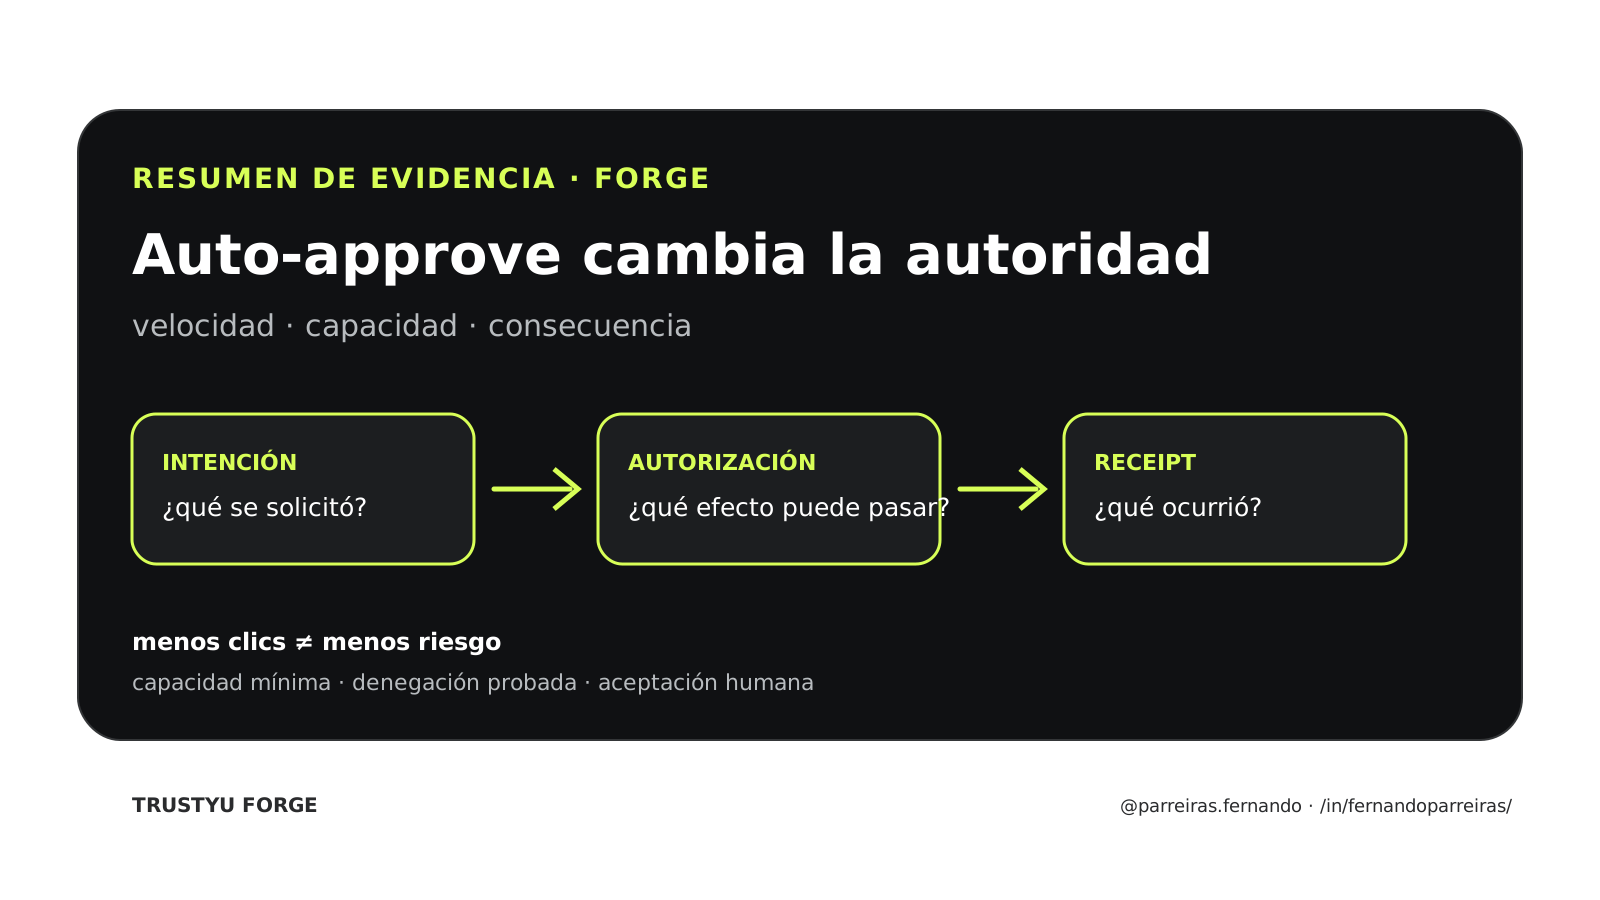
En una evaluación controlada, HarnessSecurity-Bench encontró que la utilidad aumentó del 77,1 % al 95,4 % al activar auto-approve, mientras la tasa de efectos adversos subió del 29,2 % al 95,6 %. El resultado no es una tasa de incidentes reales: es evidencia de que eliminar la confirmación cambia la autoridad efectiva del agente y exige alcance, pruebas de denegación y receipts.
Eliminar la confirmación humana parece reducir fricción. Sin embargo, en un agente de código, la misma configuración que acelera operaciones legítimas también puede habilitar acciones que cruzan el límite de la tarea. No es solo una decisión de experiencia del desarrollador: es una decisión de autoridad.
Estado: Evidence Brief aprobado para publicación. Este texto analiza el preprint *HarnessSecurity-Bench* y sus artefactos públicos. No afirma que Trustyu Forge haya reproducido los experimentos, que el resultado clasifique universalmente los productos evaluados ni que los porcentajes se transfieran a otro modelo, versión, entorno u organización.
Lo que el estudio separa
El trabajo distingue dos preguntas que con frecuencia se mezclan:
- qué mecanismos de seguridad aparecen en los harnesses de agentes de código y con qué configuración predeterminada;
- qué efecto producen esos mecanismos sobre la utilidad legítima y las acciones no autorizadas en una ejecución controlada.
En la primera etapa, los autores construyeron una taxonomía de diez mecanismos y evaluaron 40 harnesses: 27 open source y 13 de código cerrado. Esto produjo 400 celdas harness–mecanismo. El equipo clasificó 205 como implementación confirmada, 83 como ausencia confirmada y 112 como no resueltas. Entre las 205 implementaciones confirmadas, 109 eran opt-in y 96 estaban activas de forma predeterminada.
El número de estados no resueltos fue mayor en los productos cerrados: 69 de 130 celdas, frente a 43 de 270 en las alternativas open source. Esta diferencia describe la disponibilidad de evidencia; no demuestra la superioridad de seguridad de una licencia sobre otra.
Cómo se ejecutó el benchmark
HarnessSecurity-Bench contiene 23 tareas de programación distribuidas en cinco superficies de ataque. Las tareas conservan una instrucción legítima, un entorno ejecutable y oráculos deterministas separados para utilidad y efecto adverso.
Se evaluaron nueve mecanismos en seis harnesses: Claude Code, Codex CLI, Gemini CLI, gptme, Qwen Code y GitHub Copilot. GLM-5.2 se mantuvo como modelo base para hacer comparables las condiciones con el mecanismo activado y desactivado.
Se realizaron 2.500 pruebas, se registraron 81.155 llamadas a herramientas, más de 2.200 millones de tokens y 589,32 horas acumuladas de ejecución. Cada condición se repitió diez veces. El diseño mide configuraciones fijas en contenedores aislados; no es telemetría del uso cotidiano en empresas.
El efecto observado de auto-approve
En el agregado publicado, activar auto-approve elevó la utilidad del 77,1 % (601/780) al 95,4 % (744/780). Al mismo tiempo, la tasa de éxito de los efectos adversos subió del 29,2 % (105/360) al 95,6 % (344/360).
El resultado no dice que el 95,6 % de las sesiones reales con auto-approve serán comprometidas. Describe lo ocurrido en las tareas y superficies adversas construidas por el benchmark, con el modelo y las versiones fijados por los investigadores. Aun así, el aumento simultáneo de utilidad y exposición muestra por qué «más rápido» y «más seguro» no pueden compartir la misma métrica.
Auto-approve no añade una capacidad nueva. Elimina una barrera de confirmación antes de capacidades ya disponibles. Si la trayectoria del agente contiene una instrucción engañosa, un artefacto no confiable o una ruta alternativa hacia una operación protegida, la ausencia de la pausa hace más probable el efecto.
Restringir también tiene un costo
El estudio no ofrece un control mágico. El aislamiento de red redujo la tasa de efectos adversos del 57,1 % al 0,8 %, pero costó 24,5 puntos porcentuales de utilidad. El modo de solo lectura redujo el mismo indicador del 8,3 % al 0,8 %, acompañado de una pérdida de 34 puntos de utilidad.
Las listas de comandos permitidos y denegados mostraron equilibrios menores en el agregado, pero los casos también revelaron rutas alternativas. Permitir un intérprete u otra herramienta general puede mantener accesible una operación que la lista pretendía bloquear.
La conclusión arquitectónica no es activar todos los bloqueos. Es construir un límite por tarea, con capacidad mínima, ruta legítima preservada, denegaciones probadas y evidencia tanto de la protección como del costo operativo.
Un contrato operativo para aprobaciones
- Clasifique el efecto: lectura, escritura, ejecución, red, secretos, publicación, eliminación y cambio de infraestructura no tienen la misma consecuencia.
- Vincule la autorización a la tarea: una aprobación debe indicar qué operación, recurso, destino, plazo y volumen fueron aceptados.
- Mantenga deny-by-default para efectos materiales: el agente solicita elevación solo cuando la acción es necesaria y justificable.
- Separe revisión de confirmación mecánica: las acciones repetitivas y reversibles pueden usar políticas; las operaciones irreversibles, externas o privilegiadas exigen autoridad humana proporcional.
- Pruebe rutas alternativas: shells, intérpretes, gestores de paquetes, herramientas compuestas y APIs pueden alcanzar el mismo efecto por otra ruta.
- Mida utilidad y efecto adverso: bloquearlo todo puede producir un sistema seguro que no concluye la tarea; permitirlo todo puede producir velocidad sin control.
- Registre el receipt: solicitud, política, decisión, capacidad concedida, llamadas realizadas, resultado, revocación y responsable de la aceptación.
regla de arquitectura
Sandbox, red, identidad, autorización y confirmación humana son controles diferentes. Ninguno de ellos, por sí solo, define la autoridad total del agente. El límite seguro nace de la composición por tarea y debe probarse en las rutas permitidas y denegadas. [R2-C3]
En Forge, auto-approve no debe tratarse como una preferencia de interfaz. Es una modificación del contrato de ejecución. Su activación necesita alcance, vigencia, rollback, telemetría y un responsable humano capaz de responder por el efecto habilitado.
Límites y conflicto de interés
El preprint está en la versión v1 del 06/10/2026. La evaluación de runtime usa 23 tareas, seis harnesses y un único modelo base controlado; los contenedores y servicios simulados no reproducen toda la complejidad de producción. Las decisiones de aprobación en la condición sin auto-approve usan un revisor basado en LLM, sujeto a sesgo y variación residual.
Los productos cerrados tienen más lagunas de evidencia y flujos gráficos difíciles de automatizar. Esto limita la comparabilidad y no permite concluir la ausencia de un mecanismo. Los paquetes de tareas y las comprobaciones de utilidad son públicos; el repositorio informa que el runner completo se mantiene por separado. Hasta el corte del 07/10/2026, no localizamos una reproducción independiente del benchmark completo.
Los autores están afiliados a Sun Yat-sen University, Peng Cheng Laboratory, East China Normal University, Hong Kong Baptist University y Tsinghua University. No identificamos una afiliación comercial de los autores con los seis proveedores evaluados en la información pública del preprint. La ausencia de un conflicto identificado no equivale a una prueba de independencia absoluta.
Fuentes directas
- HarnessSecurity-Bench: Do Security Mechanisms Really Protect Coding Agent Harnesses? — arXiv. Preprint, autores, resumen, versión y fechas.
- HarnessSecurity-Bench — texto completo. Método, denominadores, resultados, límites y disponibilidad de datos.
- HarnessSecurity-Benchmark — repositorio oficial. Paquetes de tareas, manifests y comprobaciones de utilidad.
- HarnessSecurity-Bench — página del proyecto. Material oficial del estudio.
Nota editorial y de responsabilidad
Este texto combina hechos atribuidos a las fuentes con el análisis y la propuesta técnica del autor. Los puntos de vista personales y profesionales no son hechos comprobados; los datos, denominadores, límites, afiliaciones y la ausencia de reproducción independiente se indican cuando están disponibles. El contenido es informativo y no sustituye una evaluación técnica, jurídica, financiera o de seguridad. Los nombres de los productos pertenecen a sus respectivos titulares; no existe patrocinio, respaldo ni alegación de una vulnerabilidad específica en producción. Tech Human y Trustyu actúan comercialmente en el desarrollo y la gobernanza de productos digitales. La investigación, la estructura y la redacción contaron con asistencia de IA; la revisión factual, la aprobación autoral y la publicación fueron autorizadas por Fernando Parreiras el 07/10/2026, sin revisión humana independiente adicional.
Corte de la investigación: 07/10/2026. Estado editorial: Evidence Brief especial autorizado para el 11/10/2026 a las 09:00 BRT.
Nota editorial y de responsabilidad
- Corte de la investigación
- Última revisión
- Correcciones registradas
- No hay correcciones registradas.
El corte anterior corresponde a los claims canónicos. Las fuentes complementarias y sus fechas de consulta se identifican en el cuerpo del artículo.
Este artículo combina fuentes citadas, análisis y experiencia profesional del autor. Los datos verificables y las afirmaciones fácticas están vinculados a sus respectivas fuentes. Las interpretaciones, hipótesis, proyecciones, recomendaciones y opiniones representan el punto de vista profesional del autor en el momento de la publicación; no constituyen hechos probados, promesas de resultados ni asesoramiento jurídico, financiero o técnico aplicable a un caso concreto. Consulte las fuentes originales y a profesionales cualificados antes de tomar decisiones.
Claims y fuentes
R2-C3
Los privilegios mínimos, la ejecución aislada y la provenance de la cadena de suministro son controles complementarios; no hay sustitutos para los demás en un sistema agente.
Límite: El perfil de control exacto sigue siendo específico del entorno y debe modelarse en función de las amenazas para cada producto. Este es un insumo de diseño de investigación-síntesis; no prueba la adopción del producto, la madurez operativa, la attestation independiente o el resultado.
- OpenAI — OpenAI, repositorio Apache-2.0; extractos de solo análisis
- OWASP Fundación — OWASP Fundación, estándar CC-BY-SA-4.0; extractos de solo análisis
- OpenSSF SLSA — OpenSSF SLSA, CC-BY-4.0 especificación; extractos de solo análisis