
Lectura ejecutiva · ~60 segundos
Un estudio con 354 tareas y 2.124 ejecuciones encontró beneficios de concurrencia dinámica principalmente en trabajos largos y descomponibles, pero también un uso de tokens entre 1,41 y 3,31 veces mayor y más tiempo medio en 14 de 15 combinaciones. Paralelizar requiere contrato de estado, integración, presupuesto y aceptación.
Delegar en varios agentes parece una forma directa de terminar antes. Sin embargo, en tareas largas de ingeniería, paralelizar también crea colas, dependencias, superposición de contexto, conflictos de estado y un nuevo trabajo de integración. La pregunta técnica no es cuántos agentes caben en el flujo, sino cuándo el trabajo puede descomponerse sin perder coherencia global.
Estado: Evidence Brief aprobado para publicación. Serie editorial: Papers que leemos por ti. Este texto analiza el preprint *When Sub-Agents Work in Parallel* y sus artefactos públicos. No afirma que Trustyu Forge haya reproducido los experimentos ni que los resultados clasifiquen universalmente a Codex, Claude Code, Kimi Code o cualquier versión futura de esos productos.
Qué se comparó
Los autores evaluaron tres agentes de código con soporte nativo para concurrencia dinámica: Codex, Claude Code y Kimi Code. En cada tarea compararon dos condiciones: el agente podía decidir cuándo crear subagentes o debía ejecutar sin delegación paralela. Modelo, prompt, entorno y presupuesto de tiempo se mantuvieron equivalentes dentro de cada par.
La muestra reúne 354 tareas: 254 de cuatro benchmarks de larga duración y 100 de SWE-bench Verified, usado como referencia de trabajo más delimitado. Cada tarea se ejecutó con los tres agentes en ambas condiciones, para un total de 2.124 ejecuciones. La telemetría registró 11.200 millones de tokens y un costo estimado por los autores de US$20.780,02 con las tarifas de API usadas en el estudio.
Más capacidad no produjo una ganancia uniforme
En el agregado reportado, habilitar concurrencia dinámica cambió la resolución entre una caída de 11,9 puntos porcentuales y una ganancia de 2,3 puntos, según el agente y el conjunto. El consumo de tokens fue entre 1,41 y 3,31 veces el modo secuencial. El tiempo medio aumentó en 14 de las 15 combinaciones entre agente y benchmark.
El resultado fue sensible al tipo de trabajo. En LoopsBench, el conjunto de tareas más largas del estudio, Codex y Claude Code obtuvieron mejoras de task pass de hasta 14,3 puntos porcentuales. En SWE-bench Verified, Claude Code cayó de 83% a 59% y Kimi Code de 77% a 59%; Codex permaneció en 71% en ambas condiciones. El paralelismo ayudó donde había suficiente trabajo complementario y perjudicó cuando el costo de coordinación superó la oportunidad de descomposición.
El cuello de botella se desplaza a la integración
Una trayectoria presentada en el paper ilustra el riesgo. El agente principal creó 20 subagentes para implementar comandos de una herramienta, esperó el lote completo y no integró ni probó lo que ya estaba disponible antes del límite de tiempo. El programa compiló, pero pasó solo 92 de 440 pruebas porque partes esenciales no fueron integradas.
El análisis manual de las trayectorias produjo cuatro categorías, 13 subcategorías y 28 patrones de fallo. Los grupos cubren orquestación de tareas, gobernanza de ejecución, gestión del contexto global y estado compartido/merge. La concordancia entre anotadores se informó con un kappa de Cohen de 0,77.
Cuándo tiende a ayudar la concurrencia
El paper identifica tres mecanismos de beneficio: trabajo complementario realmente independiente, exploración de soluciones alternativas y validación separada del trabajo principal. Esto sugiere un gate antes del spawn:
- Independencia: ¿el subproblema tiene entradas y salida explícitas y puede avanzar sin editar el mismo estado que otros agentes?
- Integración: ¿existe un owner responsable de reconciliar interfaces, conflictos y efectos secundarios antes de la aceptación?
- Presupuesto: ¿la delegación preserva tiempo y tokens suficientes para integración, pruebas y corrección?
- Observabilidad: ¿es posible ver dependencias, espera, archivos modificados y resultados parciales?
- Fallback: si un subagente se retrasa o falla, ¿el principal puede usar resultados parciales o volver a la ruta secuencial?
regla de arquitectura
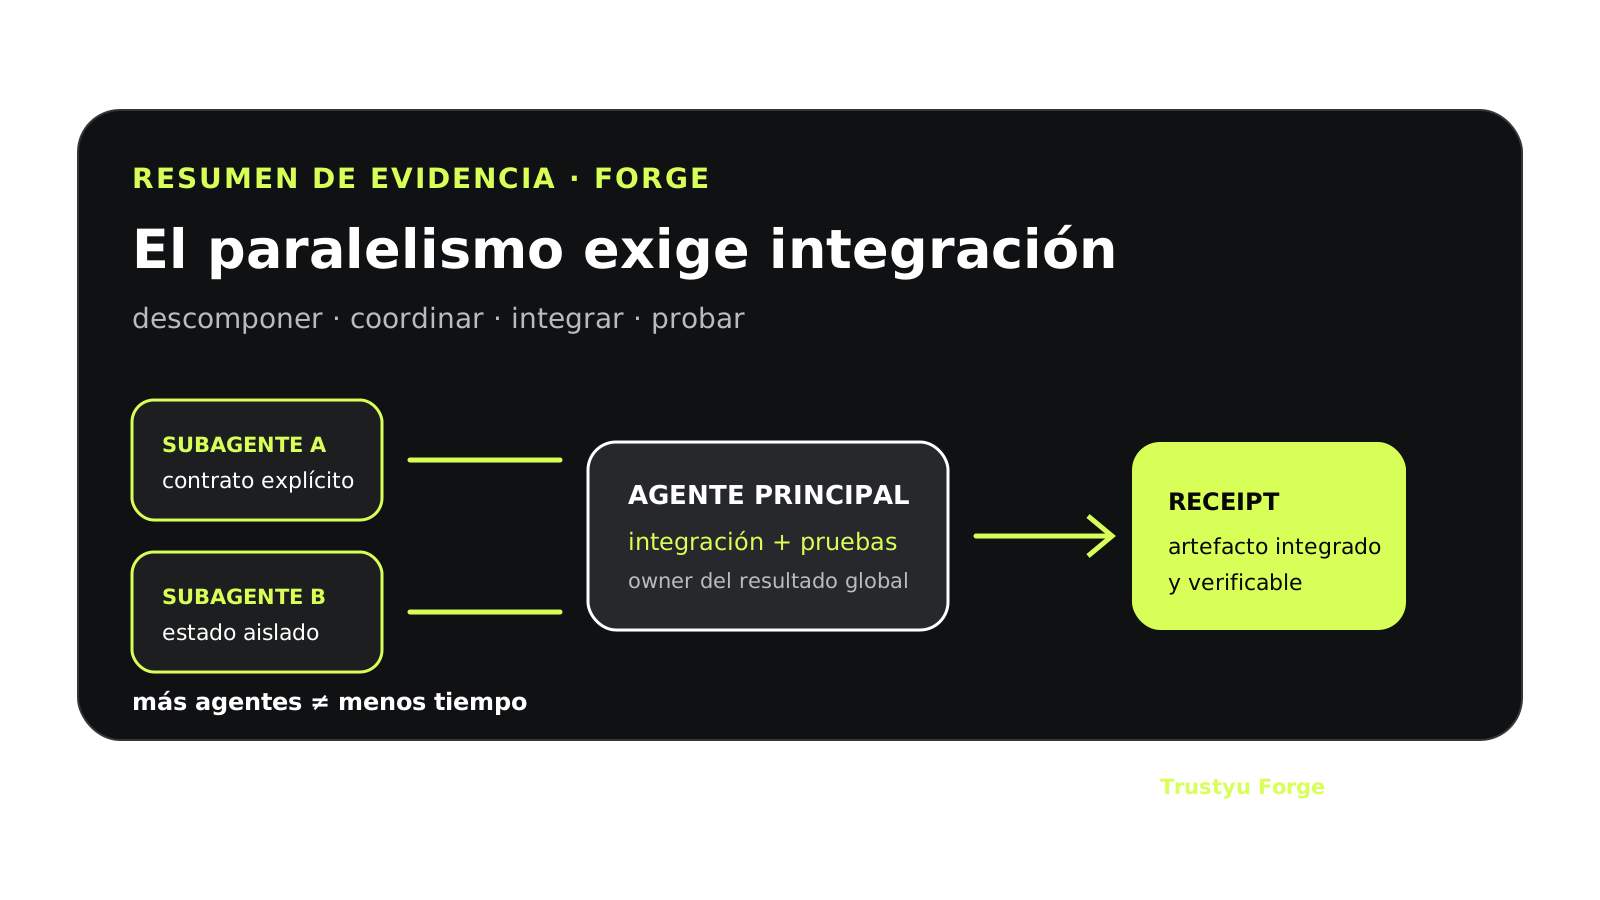
La concurrencia es una política de ejecución, no una garantía de productividad. El harness debe permitir delegación solo cuando la tarea declare fronteras de estado, contrato de entrega, presupuesto de integración y un responsable de la aceptación global. La velocidad local de los subagentes no sustituye la prueba de que el artefacto integrado cumple el contrato. [R2-C3]
En Forge, un flujo multiagente debe registrar el plan de descomposición, dependencias, contexto entregado, cambios producidos, conflictos, pruebas y aceptación. La métrica principal no es la cantidad de agentes ocupados; es el tiempo y costo hasta una entrega integrada, verificable y recuperable.
Límites y conflicto de interés
El estudio es un preprint v1 del 07/10/2026. La muestra cubre tres agentes, configuraciones elegidas en julio de 2026 y cinco benchmarks; no representa todas las herramientas, versiones, lenguajes o formas de orquestación. Las tareas se muestrearon por dificultad y, por costo, cada celda aparece una vez en el experimento principal, lo que limita las estimaciones de variación en sistemas estocásticos.
Los autores publicaron trayectorias y artefactos de análisis, pero hasta el corte editorial no localizamos una replicación independiente completa. Los autores declaran afiliaciones con Nanjing University, Central University of Finance and Economics y University of Illinois Urbana-Champaign; no localizamos afiliaciones comerciales declaradas con los tres proveedores evaluados. La ausencia de un conflicto identificado no prueba independencia absoluta.
Fuentes directas
- When Sub-Agents Work in Parallel — arXiv. Preprint, autores, resumen, versión y fecha.
- When Sub-Agents Work in Parallel — texto completo. Método, denominadores, resultados, taxonomía y limitaciones.
- Concurrency Failures Trajectory Artifact — repositorio oficial. Trayectorias y artefactos publicados por los autores.
Nota editorial y de responsabilidad
Este texto combina hechos atribuidos a las fuentes con análisis y propuesta técnica del autor. Los puntos de vista personales y profesionales no son hechos comprobados; datos, denominadores, limitaciones, afiliaciones y ausencia de replicación independiente se indican cuando están disponibles. El contenido es informativo y no sustituye una evaluación técnica, jurídica, financiera o de seguridad. Los nombres de productos pertenecen a sus titulares; no existe patrocinio ni respaldo. Tech Human y Trustyu actúan comercialmente en desarrollo y gobernanza de productos digitales. La investigación, estructura y redacción tuvieron asistencia de IA; la revisión factual, aprobación autoral y publicación fueron autorizadas por Fernando Parreiras el 08/10/2026, sin revisión humana independiente adicional.
Corte de investigación: 08/10/2026. Estado editorial: Evidence Brief especial autorizado para el 13/10/2026 a las 09:00 BRT.
Nota editorial y de responsabilidad
- Corte de la investigación
- Última revisión
- Correcciones registradas
- No hay correcciones registradas.
El corte anterior corresponde a los claims canónicos. Las fuentes complementarias y sus fechas de consulta se identifican en el cuerpo del artículo.
Este artículo combina fuentes citadas, análisis y experiencia profesional del autor. Los datos verificables y las afirmaciones fácticas están vinculados a sus respectivas fuentes. Las interpretaciones, hipótesis, proyecciones, recomendaciones y opiniones representan el punto de vista profesional del autor en el momento de la publicación; no constituyen hechos probados, promesas de resultados ni asesoramiento jurídico, financiero o técnico aplicable a un caso concreto. Consulte las fuentes originales y a profesionales cualificados antes de tomar decisiones.
Claims y fuentes
R2-C3
Los privilegios mínimos, la ejecución aislada y la provenance de la cadena de suministro son controles complementarios; no hay sustitutos para los demás en un sistema agente.
Límite: El perfil de control exacto sigue siendo específico del entorno y debe modelarse en función de las amenazas para cada producto. Este es un insumo de diseño de investigación-síntesis; no prueba la adopción del producto, la madurez operativa, la attestation independiente o el resultado.
- OpenAI — OpenAI, repositorio Apache-2.0; extractos de solo análisis
- OWASP Fundación — OWASP Fundación, estándar CC-BY-SA-4.0; extractos de solo análisis
- OpenSSF SLSA — OpenSSF SLSA, CC-BY-4.0 especificación; extractos de solo análisis