
Lectura ejecutiva · ~60 segundos
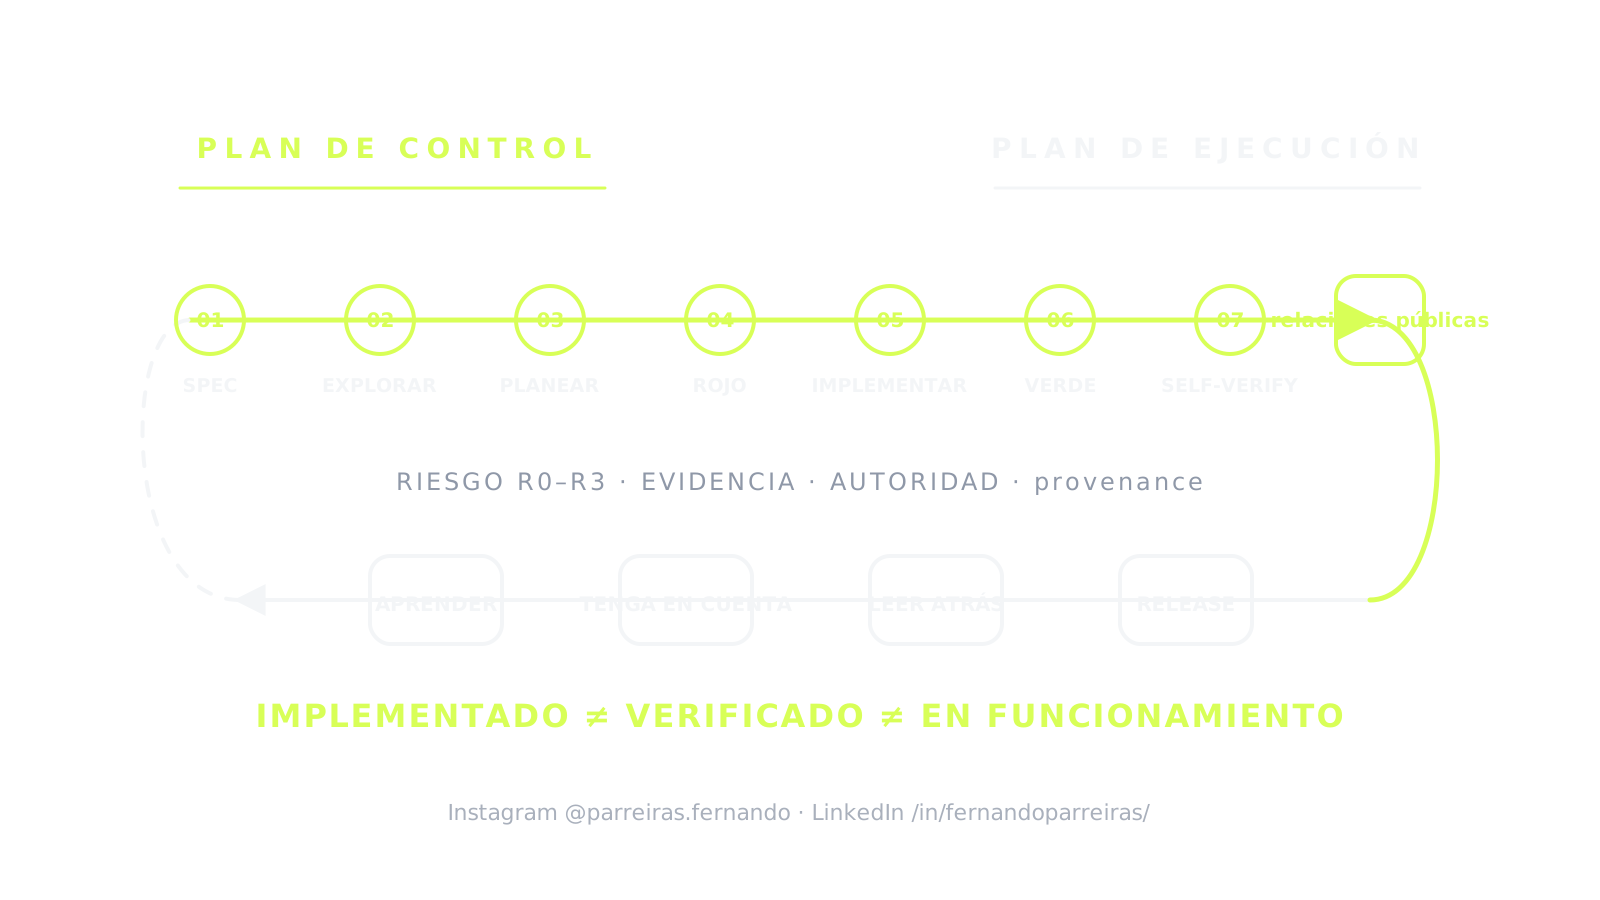
Un prompt inicia el trabajo, pero no prueba la aceptación ni la operación. FORGE organiza el ciclo SPEC → EXPLORE → PLAN → RED → IMPLEMENT → GREEN → SELF-VERIFY → PR; release, readback, observación, rollback y aprendizaje cierran la verdad operativa.
Generar código ya no es el centro de gravedad de un ciclo de software asistido por IA. El desafío pasó a ser mantener intención, autorización, ejecución, verificación y operación vinculadas a un mismo marco mientras modelos y agentes producen cambios a mayor velocidad.
Un prompt puede empezar a funcionar. No define por sí solo qué se debe aceptar, quién puede promoverlo, qué artefacto llegó al entorno o si el comportamiento se mantuvo saludable después de la implementación. Un SDLC nativo de IA confiable debe transformar la intención humana en una cadena reconstruible de decisiones y evidencia, y debe poder rechazar una entrega plausible.
Este artículo presenta el bucle técnico adoptado como referencia por FORGE:
SPEC → EXPLORE → PLAN → RED → IMPLEMENT → GREEN → SELF-VERIFY → PR
                                                               ↓
                  LEARN ← ROLLBACK/ADAPT ← OBSERVE ← RELEASE
El primer arco produce un cambio candidato. El segundo pone a prueba la verdad operativa de este cambio. PR es la frontera entre ambos; No es el final del ciclo.
Resumen ejecutivo
- SPEC antes de la generación: La intención, el alcance, la aceptación, el riesgo y la reversión deben ser explícitos antes de elegir la implementación.
- Riesgo proporcional: R0–R3 cambia la profundidad del diseño, revisión, amenaza y autoridad requerida; no se utiliza para reducir artificialmente un riesgo hasta que gate desaparezca.
- Prueba independiente: un mismo agente puede implementar y autoverificar, pero la evidencia que libera una consecuencia relevante debe fallar independientemente de su generación.
- PR no es una operación: fusionar, construir, release, implementar, leer, observar y revertir tienen su propio receipts y autoridades.
- Los estados no son sinónimos: IMPLEMENTADO, VERIFICADO y EN FUNCIONAMIENTO describen diferentes pruebas.
- FORGE+ AI funciona: FORGE organiza el plan de control; AI Works acerca el plan de ejecución. La composición es válida sólo en el ámbito implementado y calificado, no como una promesa universal.
1. SPEC: transforma la intención en contrato rechazable
El primer error de un flujo agente es preguntar "implementar esto" y tratar la respuesta del modelo como la especificación. La especificación de características livianas de FORGE corrige al menos:
| campo | Pregunta que necesitas responder | Fracaso evitado |
|---|---|---|
| objetivo y por qué | ¿Qué resultado humano queremos producir? | optimizar la actividad sin resultado |
| dentro del alcance | ¿Qué hará este cambio? | ambigüedad fronteriza |
| fuera de alcance | ¿Qué no hará ella? | expansión silenciosa del alcance |
| aceptación | ¿Qué observación puedo aprobar o rechazar? | aprobación de plausibilidad |
| pruebas/evals | ¿Qué signos materializan el contrato? | “verde” no relacionado con la intención |
| riesgo | ¿Qué consecuencias hay si nos equivocamos? | gate igual para diferentes impactos |
| revertir | ¿Cómo contener y revertir sin inventar el incidente? | cambio irreversible por defecto |
Un SPEC útil no tiene por qué tardar mucho. Tiene que ser refutable. Si no hay una condición de rechazo explícita, hay una descripción, no un contrato.
2. EXPLORAR y PLANIFICAR: contexto antes de editar
Los agentes son especialmente buenos para producir una respuesta coherente al contexto que se les presenta. Si el contexto omite convenciones, dependencias, propietarios, gates o trabajo paralelo, la coherencia puede quedar estancada en el problema equivocado.
EXPLORAR mapea la base de código real: instrucciones locales, módulos afectados, dependencias, contratos, flujos de datos, pruebas existentes, radio de explosión y trabajo en vuelo. El resultado es un mapa de impacto, no un cambio.
PLANEAR convierte este mapa en secuencia: qué contratos cambian, dónde nacen las pruebas, cómo se preservarán las fronteras, qué retroceso existe y qué decisión necesita ADR. Un plan no autoriza un efecto; hace que la propuesta sea revisable ante el aumento de coste.
Esta separación reduce un comportamiento recurrente: el agente descubre la arquitectura mientras ya está modificando el repositorio y transforma cada descubrimiento tardío en una nueva expansión del alcance.
3. ROJO → IMPLEMENTAR → VERDE: el oráculo viene antes que el generador
en paso ROJO, el contrato recibe una forma ejecutable antes de su implementación. Puede ser prueba, eval, política como código, validación de esquema, caso contradictorio o humo con un entorno real. Lo esencial es demostrar que la ausencia del comportamiento deseado es detectable.
IMPLEMENTAR Se trata entonces de un proceso guiado por este oráculo. El agente puede escribir, ejecutar, comparar e iterar sin pedirle al humano que programe línea por línea.
VERDE solo confirma que las comprobaciones declaradas pasaron en el entorno y en los bytes observados. No confirma automáticamente que:
- las pruebas representan la intención completa;
- el artefacto construido es el mismo que será promocionado;
- el entorno de producción acepta los mismos supuestos;
- el sistema permaneció sano después del cambio;
- se produjo el resultado del negocio.
O DORA 2025 describe la IA como un amplificador de las fortalezas y debilidades del sistema organizacional. El punto es amigable: más generación aumenta el valor de la retroalimentación rápida, la plataforma, la documentación, la priorización estable y los lotes pequeños; no reemplaza estos mecanismos.
4. SELF-VERIFY: verificar sin confundir autor y auditor
Se requiere autocomprobación: suite, tipos, pelusa, seguridad, cobertura, construcción, humo y las comprobaciones de SPEC se deben ejecutar a través de DoD. Pero no se le debe dar una independencia que no posee.
Hay tres preguntas diferentes:
- ¿El agente revisó su propio trabajo? Esto reduce los errores obvios.
- ¿Pudo un mecanismo independiente rechazar una versión inapropiada? Esto reduce las fallas correlacionadas.
- ¿Una autoridad humana liberó la consecuencia? Esto asigna responsabilidad.
La independencia puede provenir de un compilador, un kernel, una suite adversaria, un motor de políticas, un escáner, un revisor humano, un entorno segregado o un segundo sistema con un modo de falla diferente. Cambiar solo el prompt o el nombre del agente no garantiza la independencia.
El NIST SP 800-218A no diferencia entre código humano y código generado por IA para fines de evaluación de vulnerabilidad: ambos deben evaluarse antes de su uso. El documento cubre el desarrollo y la integración de modelos y declara el despliegue/operación de sistemas de IA fuera de su alcance. Este límite refuerza por qué el arco operativo debe continuar más allá del desarrollo gate.
5. R0–R3: autonomía proporcional a la consecuencia
La clasificación de riesgos evita dos distorsiones: máxima burocracia para cualquier cambio y máxima autonomía para cualquier tarea.
| clase | Recorte típico | Evidencia y autoridad mínimas |
|---|---|---|
| R0 | Documentación, errata o cambio mecánico. | intención, diff, verificación y release identificados |
| R1 | comportamiento local reversible | especificaciones de funciones, pruebas de contrato, autoverificación y reversión |
| R2 | Zona 1, contrato externo, agente, migración o producto cruzado | Diseño explícito, reversión comprobable y revisión de expertos |
| R3 | autenticación, tenant, facturación, seguridad, decisión estructural o producción destructiva | ADR, modelo de amenaza, verificación independiente y decisión humana |
El riesgo pertenece al efecto, no al tamaño del diff. Una línea que amplía la autoridad podría ser R3; cien líneas de documentación pueden continuar con R0. Degradar la clase para escapar de gate es una falla de gobernanza y debería ser verificable como tal.
6. El RP no cierra el SDLC
Un PR listo concentra SPEC, diff y evidencia de desarrollo. Después de él todavía hay fronteras distintas:
- fusionar: integra un cambio en una línea de código;
- construir: transforma la fuente fijada en un artefacto identificable;
- release: registra una versión y sus criterios;
- implementar: aplica el artefacto a un entorno;
- relectura: relee lo aplicado y lo compara con la intención;
- tenga en cuenta: mide el comportamiento, las fallas, el costo y la calidad dentro de un período establecido;
- retroceder/adaptar: contiene la consecuencia o produce un nuevo cambio;
- aprender: Incorpora lo que la evidencia ha cambiado en SPEC, controles y política.
Cada límite debe contener provenance: origen del artefacto SHA, artefacto digest, identidad del entorno, resultado de gate, autoridad, marcas de tiempo y referencias de evidencia. “Workflow verde” no prueba que el artefacto esperado esté funcionando; “pod Ready” no prueba el comportamiento; “sin alerta” no prueba que la observabilidad cubriera la falla relevante.
7. IMPLEMENTADO, VERIFICADO y EN FUNCIONAMIENTO
El uso de una única etiqueta de "listo" borra el tipo de evidencia disponible.
| Estado | lo que sostiene | Lo que no se sostiene solo |
|---|---|---|
| IMPLEMENTADO | El contrato o código existe en un corte fuente exacto. | corrección, integración, implementación o uso real |
| VERIFICADO | controles definidos pasados sobre el tema, la versión y el entorno identificados | Estabilidad longitudinal u operación en otro producto. |
| OPERACIÓN | la lectura y la telemetría confirman la ruta real en una ventana y denominador declarados | Eficacia universal, ausencia futura de fallos o adopción de flota. |
Una implementación puede ser verde localmente y no estar publicada. Puede existir una implementación y no tener una lectura confiable. Se puede observar una operación en un producto y no transferir madurez a otro. Preservar los tres estados impide que la intención se convierta en una narrativa de producción.
8. FORGE como plan de control; La IA funciona como un plan de ejecución
La composición prevista es sencilla de explicar y fácil de exagerar.
A FORGE organiza intención, riesgo, roles, gates, decisiones, evidencia, estados y autoridad. Es el plan de control el que responde: qué se puede avanzar, con qué evidencia y bajo qué responsabilidad.
La IA funciona reúne herramientas, agentes, entornos, ejecución y artefactos. Es el plan de ejecución diseñado para transformar una intención admitida en trabajo observable.
Juntos, forman la arquitectura para cerrar la brecha entre la intención y el cambio verificable. Esta es una dirección arquitectónica, no un certificado de funcionamiento universal. El corte fáctico del 03/11/2026 conserva cuatro límites:
- AI Works expone 12 tipos de público, pero sólo cinco pasar por la canalización de compilación y publicar el artefacto compilado (
Agent,Function,Workflow,WidgetySurface). un documentación fijada separa catálogo, recopilación y publicación. - Se mantienen especificadas las operaciones genéricas de Git Code Ops, pero sin implementar oleadas de
sdk.code, árbol privado, conjunto de cambios de Git y escritura en GitHub. oh trabajo pendiente fijado registra esta ausencia; no debe inferir una rama arbitraria, commit, push o PR. - En el corte auditado por la investigación base, el CI principal fue desactivado. En el límite actual, existe workflow: los PR reciben gates proporcional, presione hacia adentro
mainejecuta la ruta liviana y la suite completa se ejecuta todas las noches o por despacho. Esto es automatización de CI, no prueba de release, implementación u operación. - La zona de pruebas tiene implementaciones y contratos calificados, pero no admite una afirmación amplia de operación autenticada para todas las rutas. El piloto operativo FORGE 3.3 en AI Works es designado pero aún no iniciado.
Por tanto: el FORGE gana autonomía elegible; AI Works ofrece superficies reales sobre las que ejecutarlo. La palabra "operando" sólo se aplica después de que la ruta y el producto en cuestión produzcan la evidencia correspondiente. [HARNESS31-C2]
9. Contrapunto: más IA no implica menos plazo de entrega
En un experimento aleatorio con 16 desarrolladores experimentados, 246 tareas y repositorios en los que tenían un promedio de cinco años de experiencia, el MEDIDOR encontró un aumento del 19 % en el tiempo con herramientas a partir de 2025. El estudio en sí limita la generalización a otros desarrolladores, tareas y herramientas.
En febrero de 2026, METR informó que su experimento posterior adolecía de una selección y medición insuficientes para estimar de manera confiable el efecto actual; los datos brutos sugirieron una posible aceleración, pero constituyeron evidencia débil sobre el tamaño de la ganancia. esto actualización metodológica Es más útil que elegir un solo número: cambios de capacidad, cambios de comportamiento de uso y el instrumento de medición también debe evolucionar.
Un SDLC nativo de IA no debería prometer una velocidad universal. Debe medir el tiempo de entrega, el rendimiento, la estabilidad, el retrabajo, el costo y la calidad en el propio sistema, preservando denominadores y versiones.
10. Un receipt mínimo por cambio
Para reconstruir el ciclo, cada cambio relevante debería poder responder:
intent:
  spec_id: FEAT-123
  risk: R2
  source_sha: <sha>
candidate:
  artifact_digest: sha256:<digest>
  environment: staging
verification:
  contract_checks: [unit, integration, policy, smoke]
  verifier_identity: <tool-and-version>
  result: approved | rejected | inconclusive
authority:
  approved_by: <human-or-policy-owner>
  approved_at: <timestamp>
operation:
  deployment_id: <id>
  readback_digest: sha256:<digest>
  observation_window: <start/end>
  rollback_ref: <runbook-or-artifact>
receipt no necesita contener secretos, prompts privados ni datos personales. Debe contener los vínculos necesarios para demostrar que la intención, el artefacto, la verificación, la autoridad y la observación hablan del mismo cambio.
Lista de verificación para la próxima entrega
- ¿SPEC declara lo que queda fuera?
- ¿Representa la clase R0-R3 la consecuencia real?
- ¿RED demuestra que se rechaza una versión inapropiada?
- ¿Falla el comprobador correspondiente independientemente del generador?
- ¿El digest aprobado es el mismo que el artefacto promocionado?
- ¿Está la autoridad humana separada de la producción y la verificación?
- ¿Existe una lectura del entorno, no solo un registro de canalización?
- ¿Están etiquetados IMPLEMENTADO, VERIFICADO y OPERATIVO sin transferencia de alcance?
- ¿Se preparó la reversión antes del incidente?
- ¿La observación genera aprendizaje versionado y no sólo una nota de éxito?
Conclusión
El beneficio sostenible de la IA en el desarrollo no proviene de reemplazar a un programador por un prompt. Proviene de rediseñar el sistema para que los agentes avancen de forma autónoma dentro de límites explícitos, produzcan pruebas refutables y devuelvan la autoridad a los responsables de las consecuencias.
El bucle SPEC → EXPLORAR → PLANIFICAR → ROJO → IMPLEMENTAR → VERDE → SELF-VERIFY crea un cambio candidato. Release, la relectura, la observación, la reversión y el aprendizaje transforman este cambio en una operación calificada. Entre los dos arcos hay una regla simple: ninguna capa puede afirmar más de lo que permite la evidencia de su propio tema, versión y ventana.
¿Quieres aplicar el contrato a un producto real? Utilice la lista de verificación anterior en la siguiente función y hable con Fernando Parreiras o con el Trustyu Diseñar un piloto con alcance, riesgo y evidencia definidos antes de la automatización.
Fuentes directas y contexto
- Trustyu ADR-0030: desarrollo de funciones autónomas basado en especificaciones. Loop, clases R0–R3 y límites de la autonomía en la sección documental.
- Trustyu FORGE 3.3 — ciclo de vida de gate v1. gate estados, evidencia, decisión humana y límites de inferencia.
- Trustyu Obras: piloto operativo FORGE 3.3. Alcance aprobado y calificación aún pendiente.
- Trustyu AI Works — Catálogo y publicación assets. Doce tipos públicos y cinco tipos compilados/publicados en el corte.
- Trustyu AI funciona: SPEC 056 Operaciones de código Git y atraso. Decisión, alcance y estado de falta de implementación.
- DORA — Estado del desarrollo de software asistido por IA 2025. Investigación organizacional sobre la IA como amplificador y capacidades del sistema.
- NIST SP 800-218A. Perfil SSDF para desarrollo de modelos y software que los integra, con despliegue/operación fuera del alcance declarado.
- METR: IA de principios de 2025 y desarrolladores experimentados de código abierto. Experimento, resultado, población y límites.
- METR: actualización del diseño del experimento de 2026. Cambio de diseño y límites de la señal posterior.
- Fernando Parreiras — PR #66, investigación base para la campaña AGILIDADE × AI. Ensayo canónico personal, breve y dossier editorial que dio origen a este insigne compañero técnico.
Nota editorial y de responsabilidad
Este texto combina documentos normativos públicos, evidencia empírica atribuida y el análisis técnico del autor. IMPLEMENTADO, VERIFICADO y EN FUNCIONAMIENTO son estados separados; Las referencias a FORGE y AI Works describen cortes y límites identificados, no una afirmación de SDLC universal en funcionamiento. DORA, NIST, METR, GitHub y otras marcas pertenecen a sus propietarios; no hay patrocinio ni respaldo. Tech Human y Trustyu operan comercialmente en ingeniería, gobernanza y productos digitales.
La investigación, la estructura y la redacción contaron con la ayuda de AI. Fernando Parreiras autorizó el orden del día, autorrevisión de hechos y publicación el 03/11/2026; no hubo ninguna revisión humana independiente adicional.
Corte de investigación: 03/11/2026. Estado editorial: artículo técnico especial autorizado para el 10/11/2026 a las 9 a.m. BRT.
Nota editorial y de responsabilidad
- Corte de la investigación
- Última revisión
- Correcciones registradas
- No hay correcciones registradas.
El corte anterior corresponde a los claims canónicos. Las fuentes complementarias y sus fechas de consulta se identifican en el cuerpo del artículo.
Este artículo combina fuentes citadas, análisis y experiencia profesional del autor. Los datos verificables y las afirmaciones fácticas están vinculados a sus respectivas fuentes. Las interpretaciones, hipótesis, proyecciones, recomendaciones y opiniones representan el punto de vista profesional del autor en el momento de la publicación; no constituyen hechos probados, promesas de resultados ni asesoramiento jurídico, financiero o técnico aplicable a un caso concreto. Consulte las fuentes originales y a profesionales cualificados antes de tomar decisiones.
Claims y fuentes
HARNESS31-C2
Un harness duradero debe mantener el historial de sesiones, la política de orquestación y el aislamiento de ejecución como límites explícitos, mientras que los adaptadores y complementos evitan que la elección del modelo o canal se convierta en el límite de seguridad.
Límite: Las fuentes muestran dos implementaciones, no un estándar de interoperabilidad neutral. Los permisos reales deben aplicarse y probarse de forma independiente fuera de las opciones del modelo. Este es un input de diseño source-bound; no prueba la adopción del producto, la madurez operativa, la attestation independiente, la clasificación de búsqueda, la citación de IA o el resultado.
- Anthropic — Anthropic, términos de sitio propietario
- Software YC —Software YC, MIT
- Software YC —Software YC, MIT