
Lectura ejecutiva · ~60 segundos
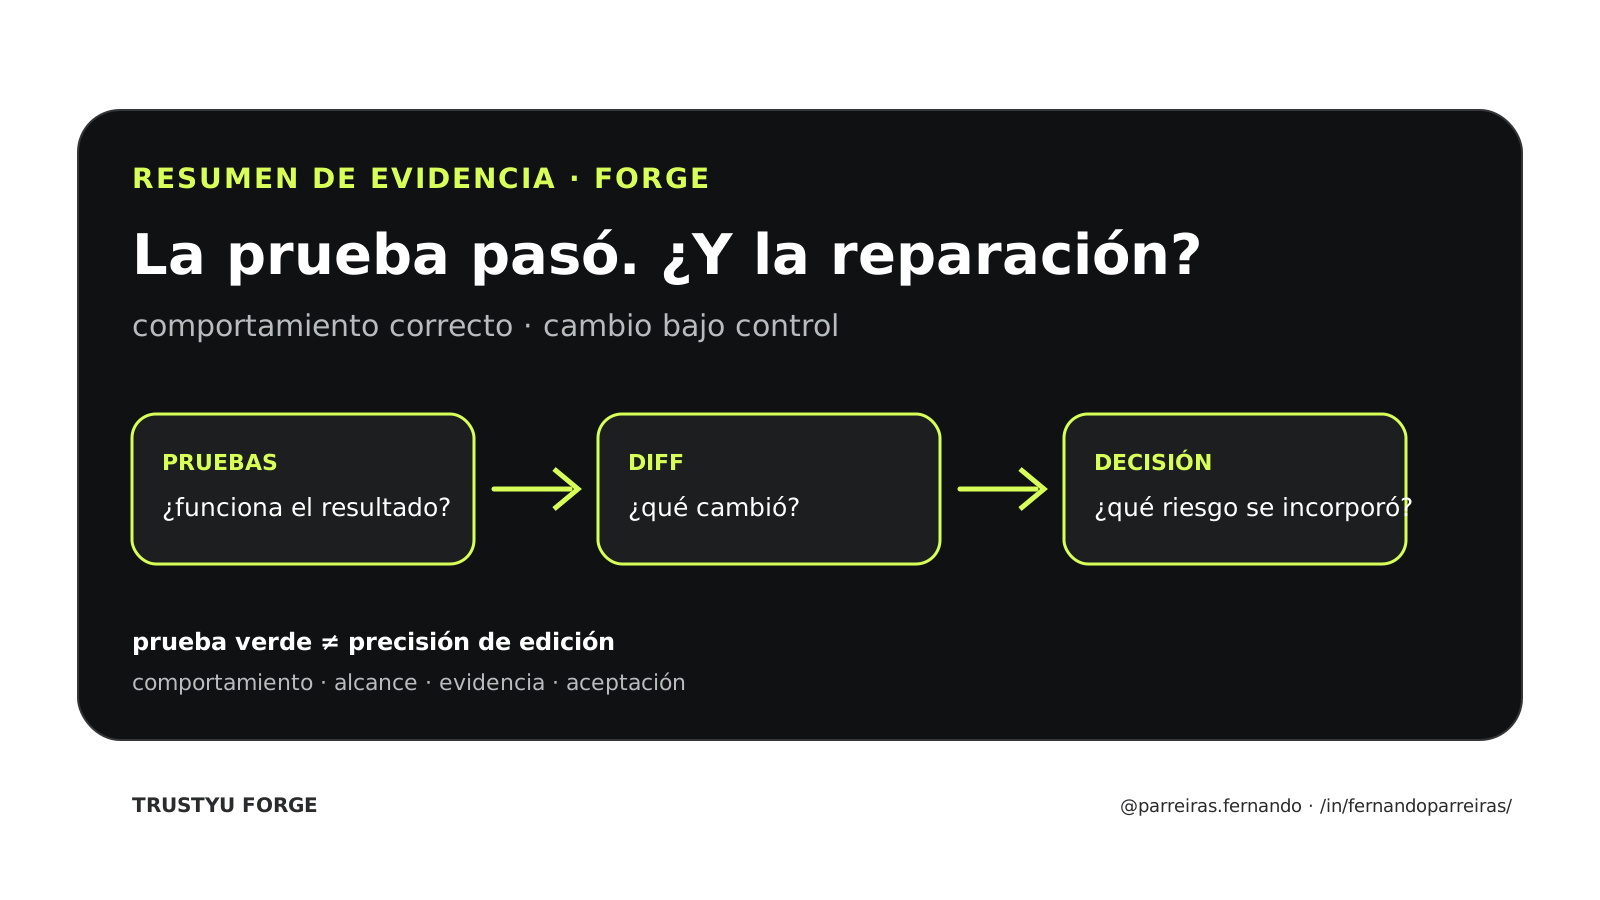
El Precise Debugging Benchmark muestra que las pruebas verdes pueden coexistir con baja precisión de edición: algunos modelos superan el 76% de aprobación, pero quedan por debajo del 45% de precisión. El resultado respalda gates que evalúan por separado el comportamiento y el radio de cambio, sin tratar la corrección de referencia como la única solución válida.
Una reparación puede satisfacer la suite y aun así modificar mucho más código de lo que exigía el defecto. Cuando los agentes tienen libertad para regenerar una función completa, la tasa de pruebas verdes deja de responder una pregunta importante: ¿el cambio fue preciso o solo encontró otro camino hacia el mismo resultado observado?
Estado: Evidence Brief aprobado para publicación. Este texto analiza el *Precise Debugging Benchmark* (PDB), un preprint con código, dataset y página de resultados públicos. No afirma que Trustyu Forge haya reproducido los experimentos ni que los resultados se transfieran automáticamente a otro lenguaje, base de código, modelo u organización.
La brecha que el benchmark intenta medir
Los benchmarks de reparación suelen preguntar si el código corregido pasa las pruebas. PDB añade dos medidas: recall de edición, que verifica cuánto de la corrección de referencia se recuperó, y precisión de edición, que mide cuánto de lo que modificó el modelo pertenece a la región esperada de la corrección.
Esta distinción importa porque un agente puede producir una solución funcional modificando líneas, funciones o estructuras no relacionadas. Para quien necesita revisar, auditar y operar software, el costo no está solo en el defecto restante. También está en el radio de cambio que debe comprenderse.
Población y método
PDB-Single parte de 7.589 ejemplos con un único defecto sintético y conserva 5.751 después de los filtros de calidad. El corpus deriva de BigCodeBench y LiveCodeBench, con programas Python y correcciones de referencia.
PDB-Wild reúne 484 tareas mayores: 256 derivadas de BigCodeBench y LiveCodeBench, seleccionadas entre programas de más de 35 líneas, y 228 derivadas de SWE-smith. Para la evaluación iterativa con agentes, los autores sortearon 500 instancias de la porción BigCodeBench.
Los investigadores comparan aprobación en pruebas unitarias, recall de edición y precisión de edición. La equivalencia con la corrección de referencia se aproxima mediante correspondencia estructural de líneas normalizadas y la menor región contigua modificada. Es una definición operativa útil, no una prueba formal de que toda edición diferente sea innecesaria.
El resultado que cambia la lectura de una prueba verde
En PDB-Single, algunos modelos de frontera superaron el 76% de aprobación en pruebas, pero permanecieron por debajo del 45% de precisión de edición. En un ejemplo reportado, Qwen3-Coder alcanzó 70% en pruebas y 66% de precisión.
El benchmark también muestra que el rendimiento funcional y la precisión no necesariamente avanzan juntos. En las rondas iterativas, permitir hasta tres intentos y ofrecer ejecución o feedback de pruebas elevó la aprobación y el recall, pero la precisión no mejoró de forma consistente y con frecuencia cayó. En el recorte presentado por los autores, Claude Code con feedback de ejecución quedó cerca del 50% de precisión.
El mensaje no es que una corrección diferente de la humana esté equivocada. El mensaje es que prueba verde y alcance del cambio son dimensiones distintas. Un equipo puede aceptar una solución alternativa, pero necesita ver qué se modificó, por qué se modificó y qué riesgo adicional se incorporó.
Validación cruzada y límites
Los autores aplicaron las mismas métricas a 40 ejemplos de bug único de DebugBench. En este recorte, GPT-5.1-Codex obtuvo 90,0% de aprobación y 61,9% de precisión; Claude Sonnet 4.5, 87,5% y 78,4%; Gemini 2.5 Pro, 85,0% y 79,4%. Esto es una validación cruzada realizada por los propios autores, no una reproducción externa independiente.
El estudio está restringido a Python. Gran parte del corpus usa defectos sintéticos; la correspondencia de edición puede penalizar soluciones correctas que difieren de la referencia; y el diseño no mide directamente mantenimiento a largo plazo, incidentes en producción ni costo de revisión. El preprint tampoco evalúa cómo influyeron los datos de entrenamiento o postentrenamiento en cada modelo.
Los autores declaran afiliaciones con University of Southern California, Microsoft, University of Wisconsin–Madison y University of Toronto, con apoyo de becas de la National Science Foundation. La afiliación corporativa no invalida los resultados, pero debe permanecer visible. Hasta el corte del 06/10/2026, no encontramos una reproducción independiente del benchmark completo.
Cómo convertir el hallazgo en un gate
- Pruebe comportamiento y alcance: mantenga la suite funcional, pero mida líneas, archivos, símbolos y dependencias modificados.
- Defina un presupuesto de cambio: cuanto mayor sea la criticidad, menor debe ser la edición no justificada.
- Pida la intención antes del patch: la hipótesis, la región esperada y el riesgo previsto hacen más visibles las desviaciones.
- Compare alternativas: cuando dos correcciones pasan, prefiera la que produce mejor evidencia — no necesariamente la menor por conteo bruto.
- Exija justificación para la expansión: un cambio fuera del área prevista necesita explicación y revisión proporcional.
- Vuelva a ejecutar las pruebas relevantes: la precisión textual no sustituye comportamiento, seguridad, compatibilidad ni observabilidad.
- Registre la aceptación humana: modelo, prompt, diff, pruebas, resultado y riesgo residual deben permanecer vinculados al commit.
regla de arquitectura
La cobertura y la aprobación de pruebas son evidencia parcial, no un veredicto de calidad. Un harness serio mantiene separadas la evidencia de comportamiento, la superficie modificada y la decisión que acepta el riesgo residual. [API31-C4]
En Forge, la pregunta después de la prueba verde debe ser: qué defecto se corrigió, qué región cambió, qué cambios no eran necesarios para la hipótesis original, qué se verificó de nuevo y quién autorizó la promoción.
Fuentes directas
- Precise Debugging Benchmark: Is Your Model Debugging or Regenerating? — arXiv. Preprint, método, muestras, resultados y limitaciones.
- PDB — página oficial y leaderboard. Resultados y descripción pública del benchmark.
- PDB — código oficial en GitHub. Implementación de las métricas y scripts de evaluación.
- PDB-Single-Hard — dataset oficial. Muestra pública del corpus.
Nota editorial y de responsabilidad
Este texto combina hechos atribuidos a las fuentes con el análisis y la propuesta técnica del autor. Los puntos de vista personales y profesionales no son hechos comprobados; se indican datos, denominadores, límites, afiliaciones y ausencia de reproducción independiente cuando están disponibles. El contenido es informativo y no sustituye una evaluación técnica, jurídica, financiera o de seguridad. Tech Human y Trustyu trabajan comercialmente en temas relacionados. La investigación, estructura y redacción tuvieron asistencia de IA; la revisión factual, aprobación autoral y publicación fueron autorizadas por Fernando Parreiras el 06/10/2026, sin revisión humana independiente adicional.
Corte de la investigación: 06/10/2026. Estado editorial: Evidence Brief especial autorizado para el 09/10/2026 a las 09h BRT.
Nota editorial y de responsabilidad
- Corte de la investigación
- Última revisión
- Correcciones registradas
- No hay correcciones registradas.
El corte anterior corresponde a los claims canónicos. Las fuentes complementarias y sus fechas de consulta se identifican en el cuerpo del artículo.
Este artículo combina fuentes citadas, análisis y experiencia profesional del autor. Los datos verificables y las afirmaciones fácticas están vinculados a sus respectivas fuentes. Las interpretaciones, hipótesis, proyecciones, recomendaciones y opiniones representan el punto de vista profesional del autor en el momento de la publicación; no constituyen hechos probados, promesas de resultados ni asesoramiento jurídico, financiero o técnico aplicable a un caso concreto. Consulte las fuentes originales y a profesionales cualificados antes de tomar decisiones.
Claims y fuentes
API31-C4
FORGE la evidencia de cobertura debe ser neutral respecto de las herramientas y normalizar al menos los campos de línea, rama, alcance, delta y umbral; SimpleCov y coverage.py siguen siendo adaptadores de idiomas, mientras que un informe de intercambio no es un veredicto de calidad.
Límite: El esquema FORGE normalizado exacto sigue siendo una decisión marco. El porcentaje de cobertura no puede demostrar la relevancia de la prueba, su corrección, la cobertura de riesgos o la ausencia de defectos. Este es un input de diseño source-bound; no prueba la adopción del producto, la madurez operativa, la attestation independiente, la clasificación de búsqueda, la citación de IA o el resultado.
- rubí — Ruby, Cláusula-de-licencia-o-BSD-2 de Ruby
- SimpleCov —SimpleCov, MIT
- coverage.py — coverage.py, Apache-2.0
- GitHub — GitHub, CC-BY-4.0
- Cobertura — Ático, GPL-2.0