
Leitura executiva
Em 112 bugs de 84 projetos, o PoC-pass chegou a 90,2% com o modelo mais novo, mas os testes dos desenvolvedores ficaram em 60,7%; 32,7% dos casos aprovados pelo PoC ainda falharam no oráculo de intenção. Um benchmark de patch precisa declarar informação, isolamento, oráculos e erros do pipeline.
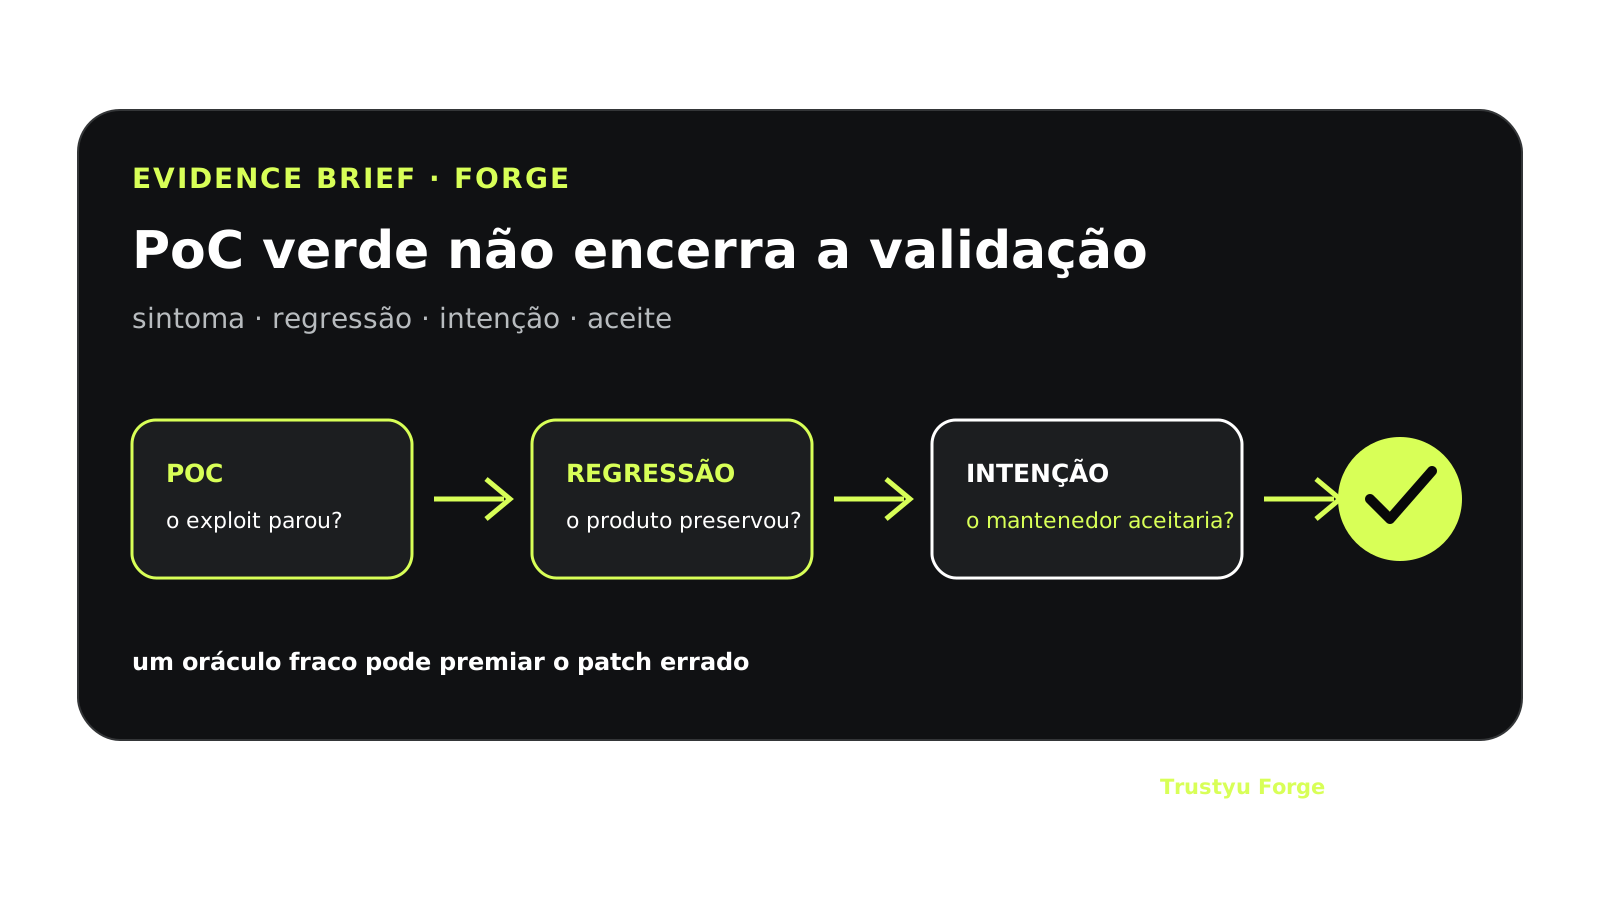
Um reparo pode impedir o exploit conhecido, preservar a suíte de regressão e ainda assim contrariar o desenho que o mantenedor aceitaria. Quando o benchmark mede somente se o Proof of Concept deixou de funcionar, supressão do sintoma pode receber o mesmo crédito que correção da causa.
Estado: Evidence Brief aprovado para publicação. Série editorial: Papers que lemos por você. Este texto analisa o preprint *On the Reliability of LLM-Based Vulnerability Patching Benchmarks*. Não afirma que a Trustyu Forge reproduziu os experimentos, que os testes dos desenvolvedores são um oráculo perfeito ou que os percentuais se transferem para outra ferramenta, modelo ou base de código.
O conjunto avaliado
Os pesquisadores curaram 112 bugs históricos de segurança em 84 projetos open source escritos em C/C++, Go e Rust. Cada caso inclui três camadas de avaliação: um PoC associado ao problema, os testes de regressão existentes e testes adicionais derivados das mudanças aceitas pelos desenvolvedores. A última camada procura capturar decisões de API, localização da correção e intenção de design que simplesmente parar o crash pode não preservar.
O estudo executou três experimentos controlados e cinco estudos de caso. Também examinou 13 benchmarks e conjuntos de vulnerabilidades existentes para identificar fatores de agente, framework e dataset que alteram o placar sem necessariamente melhorar o patch.
A diferença entre passar o PoC e atender ao mantenedor
Com o mesmo harness OpenCode e 112 casos, os autores compararam Claude Sonnet 4.0, Sonnet 4.5 e Opus 4.7. O PoC-pass reportado subiu de 77,7% para 84,8% e 90,2%. A aprovação nos testes de desenvolvedor subiu de 43,8% para 48,2% e 60,7%. As regressões ficaram em 97,3%, 94,6% e 94,6%.
Mesmo na melhor condição, 32,7% dos casos que passaram o PoC falharam nos testes dos desenvolvedores. Para Sonnet 4.0 e 4.5, essa proporção foi 43,7% e 43,2%. O resultado não significa que um terço de todo patch gerado por IA está errado. Significa que, naquele conjunto e harness, um oráculo baseado somente no PoC contou como sucesso mudanças que outro conjunto de requisitos rejeitou.
O harness também muda a pontuação
No experimento com Sonnet 4.0, fornecer instruções detalhadas de build e teste elevou o PoC-pass geral de 74,1% para 77,7%, enquanto a aprovação nos testes de desenvolvedor foi de 41,1% para 43,8%. Em C/C++, o efeito no PoC foi muito maior: 72% sem instruções e 92% com instruções. A aprovação nos testes de desenvolvedor mudou de 28% para 36%.
Isso não torna as instruções ruins; um agente precisa saber operar o projeto. O ponto é metodológico: placares não são comparáveis sem declarar qual informação, ferramenta, rede, histórico Git e feedback o harness colocou à disposição. O benchmark mede a combinação modelo–agente–harness–dataset–oráculo, não uma capacidade isolada do modelo.
Um contrato mínimo de avaliação de patches
- PoC: prova que o caminho conhecido deixou de produzir o efeito explorável.
- Regressão: protege o comportamento já coberto antes da correção.
- Intenção do mantenedor: adiciona testes para semântica, API, localização e estratégia esperadas.
- Variações adversariais: muda entradas e caminhos para distinguir correção geral de bloqueio do caso único.
- Isolamento: remove histórico, patch de referência, rede e artefatos que revelem a resposta, salvo quando esses recursos fazem parte da pergunta avaliada.
- Erros do pipeline: separa timeout, permissão, colisão de testes e falha de infraestrutura de uma falha real do patch.
- Revisão humana: preserva julgamento proporcional ao risco antes de promoção ou release.
Regra de arquitetura
O receipt de um reparo não pode ser apenas “PoC verde”. Ele deve registrar o bug, a hipótese de causa, o patch, as informações oferecidas ao agente, os oráculos executados, os efeitos colaterais, o resultado dos testes adicionados pelo mantenedor e quem aceitou a mudança. Sem essa cadeia, o placar mede uma configuração de laboratório e não prova prontidão de release. [R2-C3]
Na Forge, o conjunto de testes é um contrato de evidência com camadas e proveniência. Gerar o patch e gerar ou selecionar o oráculo são responsabilidades que precisam permanecer distinguíveis; quando a mesma trajetória controla ambos sem revisão, ela pode otimizar para a prova em vez de corrigir o produto.
Limites e conflito de interesse
O paper está na versão v1 de 07/10/2026. O conjunto é curado a partir de bugs históricos públicos, portanto pode sofrer contaminação ou memorização. Os testes adicionais derivados do upstream são um proxy de intenção, não uma especificação completa nem uma prova formal de correção. Resultados dependem do harness, prompts, ferramentas, versões dos modelos e políticas de timeout adotadas.
Até o corte editorial não localizamos replicação independente completa nem um artefato público único com todo o conjunto anunciado. Os autores declaram afiliações à Northwestern University; não localizamos conflito comercial declarado com os fornecedores de modelos citados. Ausência de conflito identificado não equivale a prova de independência absoluta.
Fontes diretas
- On the Reliability of LLM-Based Vulnerability Patching Benchmarks — arXiv. Preprint, autores, resumo, versão e data.
- On the Reliability of LLM-Based Vulnerability Patching Benchmarks — texto integral. Método, denominadores, resultados, estudos de caso, survey e limites.
Nota editorial e de responsabilidade
Este texto combina fatos atribuídos às fontes com análise e proposta técnica do autor. Pontos de vista pessoais e profissionais não são fatos comprovados; dados, denominadores, limites, afiliações e ausência de reprodução independente são indicados quando disponíveis. O conteúdo é informativo e não substitui avaliação técnica, jurídica, financeira ou de segurança. Nomes de produtos pertencem aos respectivos titulares; não há patrocínio ou endosso. Tech Human e Trustyu atuam comercialmente em desenvolvimento e governança de produtos digitais. Pesquisa, estrutura e redação tiveram assistência de IA; revisão factual, aprovação autoral e publicação foram autorizadas por Fernando Parreiras em 08/10/2026, sem revisão humana independente adicional.
Corte da pesquisa: 08/10/2026. Estado editorial: Evidence Brief especial autorizado para 15/10/2026 às 09h BRT.
Nota editorial e de responsabilidade
- Corte da pesquisa
- Última revisão
- Correções registradas
- Nenhuma correção registrada.
O corte acima corresponde aos claims canônicos. Fontes complementares e suas datas de consulta são identificadas no corpo do artigo.
Este artigo combina fontes citadas, análise e experiência profissional do autor. Dados e afirmações factuais verificáveis estão vinculados às respectivas fontes. Interpretações, hipóteses, projeções, recomendações e opiniões representam o ponto de vista profissional do autor no momento da publicação; não constituem fatos comprovados, promessa de resultado nem aconselhamento jurídico, financeiro ou técnico aplicável a um caso específico. Consulte as fontes originais e profissionais habilitados antes de tomar decisões.
Claims e fontes
R2-C3
Least privilege, isolated execution and supply-chain provenance are complementary controls; none substitutes for the others in an agentic system.
Limite: The exact control profile remains environment-specific and must be threat-modeled per product. This is a research-synthesis design input; it does not prove product adoption, operational maturity, independent attestation or outcome.
- OpenAI — OpenAI, Apache-2.0 repository; analysis-only excerpts
- OWASP Foundation — OWASP Foundation, CC-BY-SA-4.0 standard; analysis-only excerpts
- OpenSSF SLSA — OpenSSF SLSA, CC-BY-4.0 specification; analysis-only excerpts