
Leitura executiva · ~60 segundos
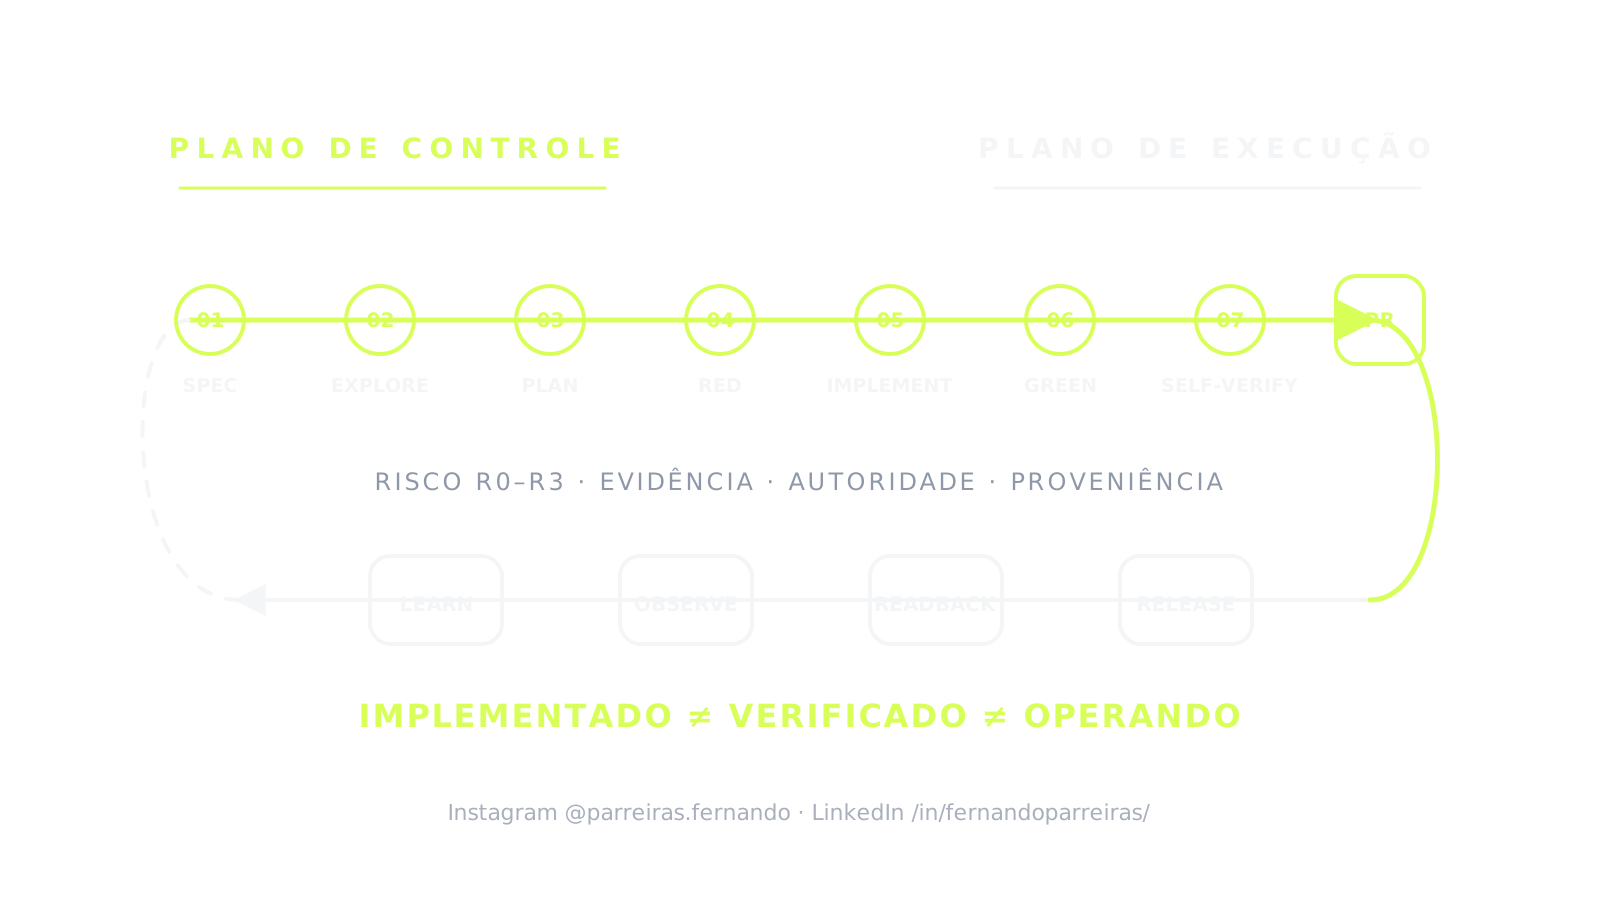
Um prompt inicia trabalho, mas não prova aceite ou operação. A FORGE organiza o ciclo SPEC → EXPLORE → PLAN → RED → IMPLEMENT → GREEN → SELF-VERIFY → PR; release, readback, observação, rollback e aprendizado fecham a verdade operacional.
Gerar código deixou de ser o centro de gravidade de um ciclo de software assistido por IA. O desafio passou a ser manter intenção, autorização, execução, verificação e operação ligadas ao mesmo recorte enquanto modelos e agentes produzem mudanças em velocidade maior.
Um prompt pode iniciar trabalho. Ele não define sozinho o que deve ser aceito, quem pode promover, qual artefato chegou ao ambiente nem se o comportamento permaneceu saudável depois do deploy. Um SDLC AI-native confiável precisa transformar intenção humana em uma cadeia reconstruível de decisões e evidências — e precisa conseguir recusar uma entrega plausível.
Este artigo apresenta o loop técnico adotado como referência pela FORGE:
SPEC → EXPLORE → PLAN → RED → IMPLEMENT → GREEN → SELF-VERIFY → PR
                                                               ↓
                  LEARN ← ROLLBACK/ADAPT ← OBSERVE ← RELEASE
O primeiro arco produz uma mudança candidata. O segundo testa a verdade operacional dessa mudança. O PR é a fronteira entre os dois; não é o fim do ciclo.
Resumo executivo
- SPEC antes da geração: intenção, escopo, fora de escopo, aceite, risco e rollback precisam ser explícitos antes de escolher a implementação.
- Risco proporcional: R0–R3 muda a profundidade de design, revisão, ameaça e autoridade exigida; não serve para reduzir artificialmente um risco até o gate desaparecer.
- Evidência independente: o mesmo agente pode implementar e auto-verificar, mas a evidência que libera uma consequência relevante precisa falhar de modo independente da geração.
- PR não é operação: merge, build, release, deploy, readback, observação e rollback têm receipts e autoridades próprios.
- Estados não são sinônimos: IMPLEMENTADO, VERIFICADO e OPERANDO descrevem provas diferentes.
- FORGE + AI Works: a FORGE organiza o plano de controle; a AI Works aproxima o plano de execução. A composição vale somente no escopo implementado e qualificado — não como promessa universal.
1. SPEC: transformar intenção em contrato recusável
O primeiro erro de um fluxo agentic é pedir “implemente isso” e tratar a resposta do modelo como a especificação. A feature-spec leve da FORGE fixa ao menos:
| Campo | Pergunta que precisa responder | Falha evitada |
|---|---|---|
| objetivo e por quê | qual resultado humano queremos produzir? | otimizar atividade sem resultado |
| in-scope | o que esta mudança fará? | ambiguidade de fronteira |
| out-of-scope | o que ela não fará? | expansão silenciosa de escopo |
| aceite | que observação pode aprovar ou rejeitar? | aprovação por plausibilidade |
| testes/evals | quais sinais materializam o contrato? | “verde” sem relação com a intenção |
| risco | que consequência existe se estivermos errados? | gate igual para impactos diferentes |
| rollback | como conter e reverter sem inventar no incidente? | mudança irreversível por omissão |
Uma SPEC útil não precisa ser longa. Precisa ser refutável. Se não existe condição explícita de rejeição, existe descrição — não contrato.
2. EXPLORE e PLAN: contexto antes de edição
Agentes são especialmente bons em produzir uma resposta coerente para o contexto que receberam. Se o contexto omite convenções, dependências, owners, gates ou trabalho paralelo, a coerência pode estar presa ao problema errado.
EXPLORE mapeia o codebase real: instruções locais, módulos afetados, dependências, contratos, fluxos de dados, testes existentes, blast radius e trabalho em voo. A saída é um mapa de impacto, não uma mudança.
PLAN converte esse mapa em sequência: quais contratos mudam, onde os testes nascem, como as fronteiras serão preservadas, qual rollback existe e qual decisão precisa de ADR. Um plano não autoriza um efeito; ele torna a proposta revisável antes do custo maior.
Essa separação reduz um comportamento recorrente: o agente descobrir a arquitetura enquanto já está modificando o repositório e transformar cada descoberta tardia em nova expansão de escopo.
3. RED → IMPLEMENT → GREEN: o oráculo vem antes do gerador
No passo RED, o contrato recebe uma forma executável antes da implementação. Pode ser teste, eval, policy-as-code, validação de schema, caso adversarial ou smoke com ambiente real. O essencial é provar que a ausência do comportamento desejado é detectável.
IMPLEMENT é então um processo orientado por esse oráculo. O agente pode escrever, executar, comparar e iterar sem pedir ao humano que programe linha a linha.
GREEN confirma apenas que os checks declarados passaram no ambiente e nos bytes observados. Não confirma automaticamente que:
- os testes representam toda a intenção;
- o artefato construído é o mesmo que será promovido;
- o ambiente de produção aceita as mesmas premissas;
- o sistema continuou saudável depois da mudança;
- o resultado de negócio ocorreu.
O DORA 2025 descreve IA como amplificador das forças e fraquezas do sistema organizacional. O ponto é compatível com o loop: mais geração aumenta o valor de feedback rápido, plataforma, documentação, priorização estável e pequenos lotes; não substitui esses mecanismos.
4. SELF-VERIFY: verificar sem confundir autor e auditor
Auto-verificação é necessária: suíte, tipos, lint, segurança, cobertura, build, smoke e checks da SPEC devem ser executados até o DoD. Mas ela não deve receber uma independência que não possui.
Há três perguntas diferentes:
- O agente revisou o próprio trabalho? Isso reduz erros óbvios.
- Um mecanismo independente conseguiu rejeitar uma versão inadequada? Isso reduz falhas correlacionadas.
- Uma autoridade humana liberou a consequência? Isso atribui responsabilidade.
Independência pode vir de um compilador, kernel, suíte adversarial, policy engine, scanner, reviewer humano, ambiente segregado ou segundo sistema com modo de falha diferente. Trocar apenas o prompt ou o nome do agente não garante independência.
O NIST SP 800-218A não diferencia código humano de código gerado por IA para fins de avaliação de vulnerabilidades: ambos precisam ser avaliados antes do uso. O documento cobre desenvolvimento e integração de modelos, e declara deployment/operação de sistemas de IA fora de seu escopo. Esse limite reforça por que o arco operacional precisa continuar depois do gate de desenvolvimento.
5. R0–R3: autonomia proporcional à consequência
A classificação de risco evita duas distorções: burocracia máxima para qualquer mudança e autonomia máxima para qualquer tarefa.
| Classe | Recorte típico | Evidência e autoridade mínimas |
|---|---|---|
| R0 | documentação, typo ou mudança mecânica | intenção, diff, verificação e release identificados |
| R1 | comportamento local reversível | feature-spec, testes do contrato, self-verify e rollback |
| R2 | Zona 1, contrato externo, agente, migração ou cross-product | design explícito, rollback testável e revisão especializada |
| R3 | auth, tenant, billing, segurança, decisão estrutural ou produção destrutiva | ADR, threat model, verificação independente e decisão humana |
O risco pertence ao efeito, não ao tamanho do diff. Uma linha que amplia autoridade pode ser R3; cem linhas de documentação podem continuar R0. Rebaixar a classe para escapar do gate é uma falha de governança e deve ser verificável como tal.
6. O PR não encerra o SDLC
Um PR pronto concentra SPEC, diff e evidências de desenvolvimento. Depois dele ainda existem fronteiras distintas:
- merge: integra uma mudança numa linha de código;
- build: transforma source pinado em artefato identificável;
- release: registra uma versão e seus critérios;
- deploy: aplica o artefato a um ambiente;
- readback: lê de volta o que foi aplicado e compara com a intenção;
- observe: mede comportamento, falhas, custo e qualidade numa janela declarada;
- rollback/adapt: contém a consequência ou produz nova mudança;
- learn: incorpora o que a evidência mudou na SPEC, nos checks e na política.
Cada fronteira precisa carregar proveniência: source SHA, digest do artefato, identidade do ambiente, resultado do gate, autoridade, timestamps e referências de evidência. “Workflow verde” não prova que o artefato esperado está operando; “pod Ready” não prova o comportamento; “sem alerta” não prova que a observabilidade cobriu a falha relevante.
7. IMPLEMENTADO, VERIFICADO e OPERANDO
Usar um único rótulo “pronto” apaga o tipo de evidência disponível.
| Estado | O que sustenta | O que não sustenta sozinho |
|---|---|---|
| IMPLEMENTADO | contrato ou código existe num source cut exato | correção, integração, deploy ou uso real |
| VERIFICADO | checks definidos passaram sobre sujeito, versão e ambiente identificados | estabilidade longitudinal ou operação em outro produto |
| OPERANDO | readback e telemetria confirmam o caminho real numa janela e denominador declarados | eficácia universal, ausência futura de falhas ou adoção de frota |
Uma implementação pode estar verde localmente e não ter sido publicada. Um deploy pode existir e não ter readback confiável. Uma operação pode ser observada num produto e não transferir maturidade para outro. Preservar os três estados impede que intenção vire narrativa de produção.
8. FORGE como plano de controle; AI Works como plano de execução
A composição pretendida é simples de explicar e fácil de exagerar.
A FORGE organiza intenção, risco, papéis, gates, decisões, evidências, estados e autoridade. Ela é o plano de controle que responde: o que pode avançar, com quais provas e sob qual responsabilidade.
A AI Works aproxima ferramentas, agentes, ambientes, execução e artefatos. Ela é o plano de execução projetado para transformar uma intenção admitida em trabalho observável.
Juntas, formam a arquitetura para reduzir a distância entre intenção e mudança verificável. Essa é uma direção arquitetural, não um certificado de operação universal. O corte factual de 03/11/2026 preserva quatro limites:
- A AI Works expõe 12 kinds públicos, mas somente cinco passam pelo pipeline de build e publicação de artefato compilado (
Agent,Function,Workflow,WidgeteSurface). A documentação pinada separa catálogo, compilação e publicação. - Git Code Ops genérico continua especificado, porém sem implementação das ondas de
sdk.code, árvore privada, changeset Git e escrita GitHub. O backlog pinado registra essa ausência; não se deve inferir branch, commit, push ou PR arbitrário. - No corte auditado pela pesquisa-base, a CI principal estava desativada. No corte atual, o workflow existe: PRs recebem gates proporcionais, push em
mainexecuta o caminho leve e a suíte completa roda à noite ou por dispatch. Isso é automação de CI, não prova de release, deploy ou operação. - O sandbox possui contratos e implementações qualificadas por recortes, mas não sustenta uma alegação ampla de operação autenticada para todos os caminhos. O piloto operacional FORGE 3.3 na AI Works está designado, mas ainda não iniciado.
Portanto: a FORGE torna a autonomia qualificável; a AI Works oferece superfícies reais para executá-la. A palavra “operando” só cabe depois que o caminho e o produto em questão produzirem a evidência correspondente. [HARNESS31-C2]
9. Contraponto: mais IA não implica menor lead time
Em um experimento randomizado com 16 desenvolvedores experientes, 246 tarefas e repositórios nos quais eles tinham em média cinco anos de experiência, a METR encontrou aumento de 19% no tempo com ferramentas de início de 2025. O próprio estudo limita a generalização para outros desenvolvedores, tarefas e ferramentas.
Em fevereiro de 2026, a METR informou que seu experimento posterior sofria seleção e medição insuficientes para estimar com confiança o efeito atual; os dados brutos sugeriam possível speedup, mas constituíam evidência fraca sobre o tamanho do ganho. Essa atualização metodológica é mais útil do que escolher apenas um número: a capacidade muda, o comportamento de uso muda e o instrumento de medição também precisa evoluir.
Um SDLC AI-native não deve prometer velocidade universal. Deve medir lead time, throughput, estabilidade, retrabalho, custo e qualidade no próprio sistema, preservando denominadores e versões.
10. Um receipt mínimo por mudança
Para reconstruir o ciclo, cada mudança relevante deveria conseguir responder:
intent:
  spec_id: FEAT-123
  risk: R2
  source_sha: <sha>
candidate:
  artifact_digest: sha256:<digest>
  environment: staging
verification:
  contract_checks: [unit, integration, policy, smoke]
  verifier_identity: <tool-and-version>
  result: approved | rejected | inconclusive
authority:
  approved_by: <human-or-policy-owner>
  approved_at: <timestamp>
operation:
  deployment_id: <id>
  readback_digest: sha256:<digest>
  observation_window: <start/end>
  rollback_ref: <runbook-or-artifact>
O receipt não precisa conter segredos, prompts privados ou dados pessoais. Ele precisa conter as ligações necessárias para provar que intenção, artefato, verificação, autoridade e observação falam da mesma mudança.
Checklist para a próxima entrega
- A SPEC declara o que fica fora?
- A classe R0–R3 representa a consequência real?
- O RED prova que uma versão inadequada é rejeitada?
- O verificador relevante falha de modo independente do gerador?
- O digest aprovado é o mesmo do artefato promovido?
- A autoridade humana está separada da produção e da verificação?
- Existe readback do ambiente, não apenas log do pipeline?
- IMPLEMENTADO, VERIFICADO e OPERANDO estão rotulados sem transferência de escopo?
- O rollback foi preparado antes do incidente?
- A observação gera aprendizado versionado, e não apenas uma anotação de sucesso?
Conclusão
O ganho sustentável de IA no desenvolvimento não vem de substituir um programador por um prompt. Vem de redesenhar o sistema para que agentes avancem com autonomia dentro de fronteiras explícitas, produzam evidência recusável e devolvam autoridade a quem responde pela consequência.
O loop SPEC → EXPLORE → PLAN → RED → IMPLEMENT → GREEN → SELF-VERIFY cria uma mudança candidata. Release, readback, observação, rollback e aprendizado transformam essa mudança em operação qualificada. Entre os dois arcos existe uma regra simples: nenhuma camada pode afirmar mais do que a evidência do seu próprio sujeito, versão e janela permite.
Quer aplicar o contrato em um produto real? Use o checklist acima na próxima feature e fale com Fernando Parreiras ou com a Trustyu para desenhar um piloto com escopo, risco e evidência definidos antes da automação.
Fontes diretas e contexto
- Trustyu ADR-0030 — Spec-Driven Autonomous Feature Development. Loop, classes R0–R3 e fronteiras de autonomia no corte documental.
- Trustyu FORGE 3.3 — gate lifecycle v1. Estados de gate, evidência, decisão humana e limites de inferência.
- Trustyu Works — piloto operacional FORGE 3.3. Escopo aprovado e qualificação ainda pendente.
- Trustyu AI Works — catálogo e publicação de assets. Doze kinds públicos e cinco kinds compilados/publicados no corte.
- Trustyu AI Works — SPEC 056 Git Code Ops e backlog. Decisão, escopo e estado não implementado.
- DORA — State of AI-assisted Software Development 2025. Pesquisa organizacional sobre IA como amplificador e capacidades do sistema.
- NIST SP 800-218A. Perfil SSDF para desenvolvimento de modelos e software que os integra, com deployment/operação fora do escopo declarado.
- METR — Early-2025 AI and experienced open-source developers. Experimento, resultado, população e limites.
- METR — 2026 experiment-design update. Mudança de desenho e limites do sinal posterior.
- Fernando Parreiras — PR #66, pesquisa-base da campanha AGILIDADE × IA. Ensaio canônico pessoal, brief e dossiê editorial que originaram este companion técnico distinto.
Nota editorial e de responsabilidade
Este texto combina documentos normativos públicos, evidência empírica atribuída e análise técnica do autor. IMPLEMENTADO, VERIFICADO e OPERANDO são estados separados; referências a FORGE e AI Works descrevem cortes e limites identificados, não uma alegação de SDLC universal em operação. DORA, NIST, METR, GitHub e demais marcas pertencem a seus titulares; não há patrocínio ou endosso. Tech Human e Trustyu atuam comercialmente em engenharia, governança e produtos digitais.
Pesquisa, estrutura e redação tiveram assistência de IA. Fernando Parreiras autorizou a pauta, a auto-revisão factual e a publicação em 03/11/2026; não houve revisão humana independente adicional.
Corte da pesquisa: 03/11/2026. Estado editorial: artigo técnico especial autorizado para 10/11/2026 às 09h BRT.
Nota editorial e de responsabilidade
- Corte da pesquisa
- Última revisão
- Correções registradas
- Nenhuma correção registrada.
O corte acima corresponde aos claims canônicos. Fontes complementares e suas datas de consulta são identificadas no corpo do artigo.
Este artigo combina fontes citadas, análise e experiência profissional do autor. Dados e afirmações factuais verificáveis estão vinculados às respectivas fontes. Interpretações, hipóteses, projeções, recomendações e opiniões representam o ponto de vista profissional do autor no momento da publicação; não constituem fatos comprovados, promessa de resultado nem aconselhamento jurídico, financeiro ou técnico aplicável a um caso específico. Consulte as fontes originais e profissionais habilitados antes de tomar decisões.
Claims e fontes
HARNESS31-C2
A durable harness should keep session history, orchestration policy and execution isolation as explicit boundaries, while adapters and plugins prevent model or channel choice from becoming the security boundary.
Limite: The sources show two implementations, not a neutral interoperability standard. Actual permissions must be independently enforced and tested outside model choice. This is a source-bound design input; it does not prove product adoption, operational maturity, independent attestation, search ranking, AI citation or outcome.
- Anthropic — Anthropic, proprietary-site-terms
- YC Software — YC Software, MIT
- YC Software — YC Software, MIT