
Leitura executiva · ~60 segundos
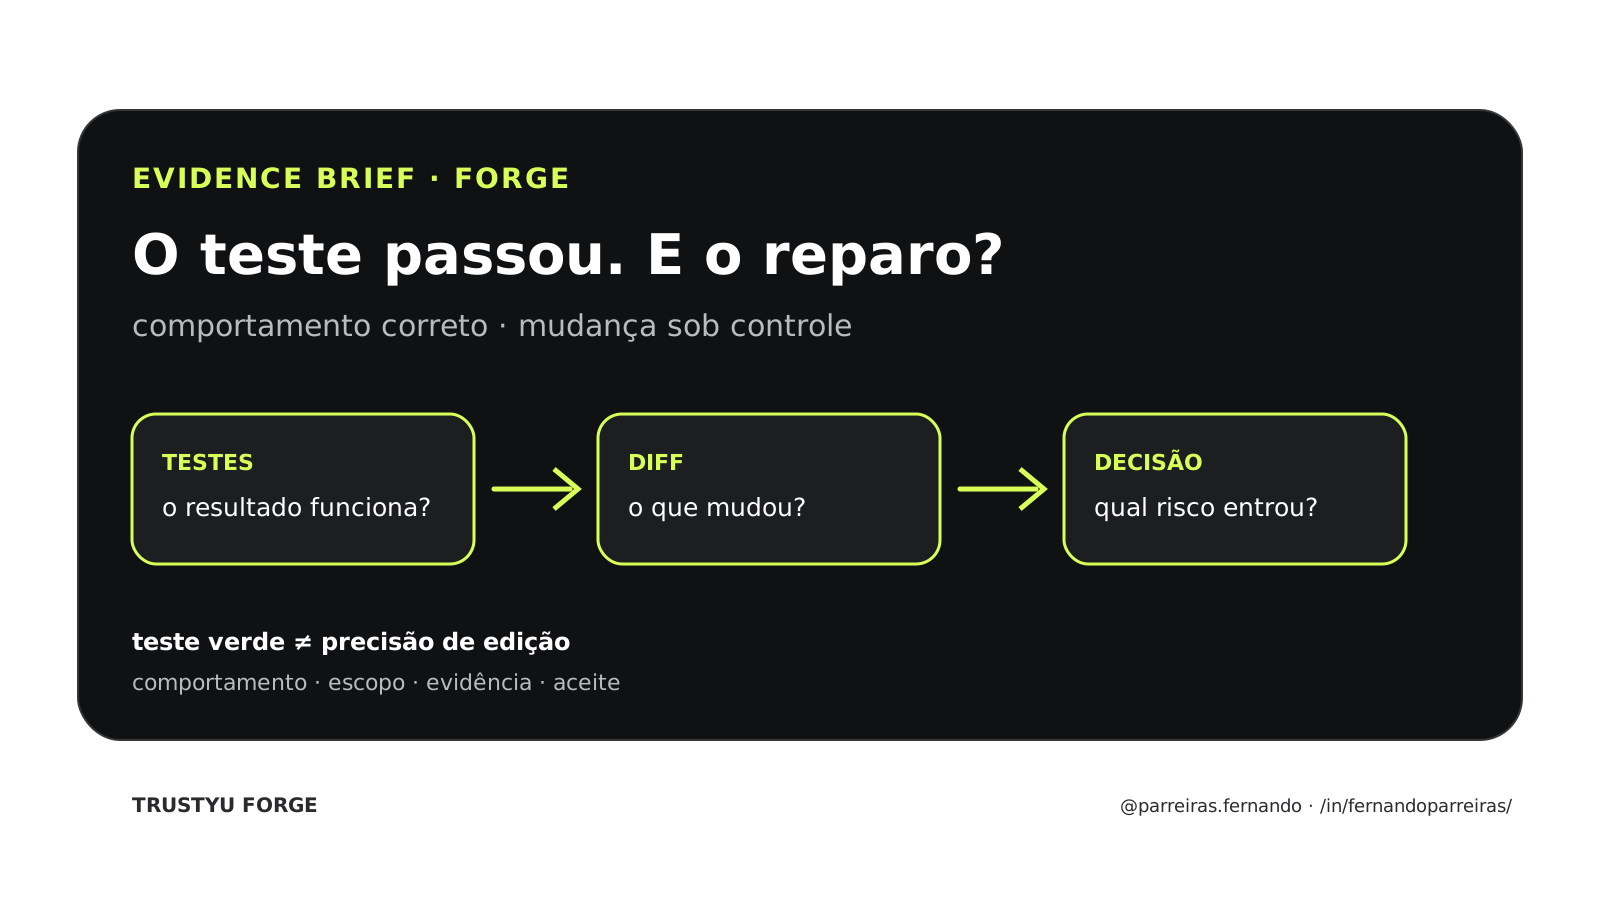
O Precise Debugging Benchmark mostra que testes verdes podem conviver com baixa precisão de edição: alguns modelos superam 76% de aprovação, mas ficam abaixo de 45% de precisão. O resultado sustenta gates que avaliam comportamento e raio de mudança separadamente, sem tratar a correção de referência como única solução válida.
Um reparo pode satisfazer a suíte e ainda modificar muito mais código do que o defeito exigia. Quando agentes recebem liberdade para regenerar uma função inteira, a taxa de testes verdes deixa de responder uma pergunta importante: a mudança foi precisa ou apenas encontrou outro caminho para o mesmo resultado observado?
Estado: Evidence Brief aprovado para publicação. Este texto analisa o *Precise Debugging Benchmark* (PDB), um preprint com código, dataset e página de resultados públicos. Não afirma que a Trustyu Forge reproduziu os experimentos nem que os resultados se transferem automaticamente para outra linguagem, base de código, modelo ou organização.
A lacuna que o benchmark tenta medir
Benchmarks de reparo costumam perguntar se o código corrigido passa nos testes. O PDB acrescenta duas medidas: recall de edição, que verifica quanto da correção de referência foi recuperado, e precisão de edição, que mede quanto do que o modelo alterou pertence à região esperada da correção.
Essa distinção importa porque um agente pode produzir uma solução funcional alterando linhas, funções ou estruturas não relacionadas. Para quem precisa revisar, auditar e operar software, o custo não está apenas no defeito remanescente. Está também no raio de mudança que precisa ser compreendido.
População e método
O PDB-Single parte de 7.589 exemplos com um único defeito sintético e mantém 5.751 depois dos filtros de qualidade. O corpus deriva de BigCodeBench e LiveCodeBench, com programas Python e correções de referência.
O PDB-Wild reúne 484 tarefas maiores: 256 derivadas de BigCodeBench e LiveCodeBench, selecionadas entre programas com mais de 35 linhas, e 228 derivadas de SWE-smith. Para a avaliação iterativa com agentes, os autores sortearam 500 instâncias da parcela BigCodeBench.
Os pesquisadores comparam aprovação em testes unitários, recall de edição e precisão de edição. A equivalência com a correção de referência é aproximada por correspondência estrutural de linhas normalizadas e pela menor região contígua alterada. É uma definição operacional útil, não uma prova formal de que toda edição diferente seja desnecessária.
O resultado que muda a leitura do teste verde
No PDB-Single, alguns modelos de fronteira ultrapassaram 76% de aprovação nos testes, mas permaneceram abaixo de 45% de precisão de edição. Em um exemplo reportado, Qwen3-Coder alcançou 70% nos testes e 66% de precisão.
O benchmark também mostra que desempenho funcional e precisão não se movem necessariamente juntos. Nas rodadas iterativas, permitir até três tentativas e fornecer execução ou feedback de testes elevou a aprovação e o recall, mas a precisão não melhorou de forma consistente e frequentemente caiu. No recorte apresentado pelos autores, Claude Code com feedback de execução ficou em torno de 50% de precisão.
O recado não é que uma correção diferente da humana esteja errada. O recado é que teste verde e escopo de mudança são dimensões distintas. Uma equipe pode aceitar uma solução alternativa, mas precisa enxergar o que foi alterado, por que foi alterado e qual risco adicional entrou junto.
Validação cruzada e limites
Os autores aplicaram as mesmas métricas a 40 exemplos de bug único do DebugBench. Nesse recorte, GPT-5.1-Codex obteve 90,0% de aprovação e 61,9% de precisão; Claude Sonnet 4.5, 87,5% e 78,4%; Gemini 2.5 Pro, 85,0% e 79,4%. Isso é uma validação cruzada conduzida pelos próprios autores, não uma reprodução externa independente.
O estudo está restrito a Python. Grande parte do corpus usa defeitos sintéticos; a correspondência de edição pode penalizar soluções corretas que diferem da referência; e o desenho não mede diretamente manutenção de longo prazo, incidentes em produção ou custo de revisão. O preprint também não avalia como dados de treinamento ou pós-treinamento influenciaram cada modelo.
Os autores declaram afiliações à University of Southern California, Microsoft, University of Wisconsin–Madison e University of Toronto, com apoio de bolsas da National Science Foundation. Afiliação corporativa não invalida resultados, mas deve permanecer visível. Até o corte de 06/10/2026, não localizamos reprodução independente do benchmark completo.
Como transformar o achado em gate
- Teste comportamento e escopo: mantenha a suíte funcional, mas meça linhas, arquivos, símbolos e dependências alterados.
- Defina orçamento de mudança: quanto maior a criticidade, menor deve ser a edição não justificada.
- Peça a intenção antes do patch: hipótese, região esperada e risco previsto tornam desvios mais visíveis.
- Compare alternativas: quando duas correções passam, prefira a que produz evidência melhor — não necessariamente a menor por contagem bruta.
- Exija justificativa para expansão: mudança fora da área prevista precisa de explicação e revisão proporcional.
- Reexecute testes relevantes: precisão textual não substitui comportamento, segurança, compatibilidade ou observabilidade.
- Registre o aceite humano: modelo, prompt, diff, testes, resultado e risco residual devem permanecer ligados ao commit.
Regra de arquitetura
Cobertura e aprovação são evidências parciais, não um veredito de qualidade. Um harness sério mantém separadas a evidência de comportamento, a superfície modificada e a decisão que aceita o risco residual. [API31-C4]
No Forge, a pergunta depois do teste verde deve ser: qual defeito foi corrigido, qual região mudou, quais mudanças não eram necessárias para a hipótese original, o que foi novamente verificado e quem autorizou a promoção.
Fontes diretas
- Precise Debugging Benchmark: Is Your Model Debugging or Regenerating? — arXiv. Preprint, método, amostras, resultados e limitações.
- PDB — página oficial e leaderboard. Resultados e descrição pública do benchmark.
- PDB — código oficial no GitHub. Implementação das métricas e scripts de avaliação.
- PDB-Single-Hard — dataset oficial. Amostra pública do corpus.
Nota editorial e de responsabilidade
Este texto combina fatos atribuídos às fontes com análise e proposta técnica do autor. Pontos de vista pessoais e profissionais não são fatos comprovados; dados, denominadores, limites, afiliações e ausência de reprodução independente são indicados quando disponíveis. O conteúdo é informativo e não substitui avaliação técnica, jurídica, financeira ou de segurança. Tech Human e Trustyu atuam comercialmente em temas relacionados. Pesquisa, estrutura e redação tiveram assistência de IA; revisão factual, aprovação autoral e publicação foram autorizadas por Fernando Parreiras em 06/10/2026, sem revisão humana independente adicional.
Corte da pesquisa: 06/10/2026. Estado editorial: Evidence Brief especial autorizado para 09/10/2026 às 09h BRT.
Nota editorial e de responsabilidade
- Corte da pesquisa
- Última revisão
- Correções registradas
- Nenhuma correção registrada.
O corte acima corresponde aos claims canônicos. Fontes complementares e suas datas de consulta são identificadas no corpo do artigo.
Este artigo combina fontes citadas, análise e experiência profissional do autor. Dados e afirmações factuais verificáveis estão vinculados às respectivas fontes. Interpretações, hipóteses, projeções, recomendações e opiniões representam o ponto de vista profissional do autor no momento da publicação; não constituem fatos comprovados, promessa de resultado nem aconselhamento jurídico, financeiro ou técnico aplicável a um caso específico. Consulte as fontes originais e profissionais habilitados antes de tomar decisões.
Claims e fontes
API31-C4
FORGE coverage evidence should be tool-neutral and normalize at least line, branch, scope, delta and threshold fields; SimpleCov and coverage.py remain language adapters, while an interchange report is not a quality verdict.
Limite: The exact normalized FORGE schema remains a framework decision. Coverage percentage cannot prove test relevance, correctness, risk coverage or absence of defects. This is a source-bound design input; it does not prove product adoption, operational maturity, independent attestation, search ranking, AI citation or outcome.
- Ruby — Ruby, Ruby-License-or-BSD-2-Clause
- SimpleCov — SimpleCov, MIT
- coverage.py — coverage.py, Apache-2.0
- GitHub — GitHub, CC-BY-4.0
- Cobertura — Cobertura, GPL-2.0